DeepInfer არის DeepSeek-ის საკუთარი ინფერენსის ფრეიმვორკი. სწორედ ის ამუშავებს კომპანიის დიდ საწარმოო სერვისებს, ახლა კი მისი კოდი ყველასთვის ღიაა. ჩინურმა კომპანიამ ეს თავის ოფიციალურ X ანგარიშზე გამოაცხადა. DeepSeek-ის განცხადებით, ეს ის სისტემაა, რომელიც DeepSeek-V4.1-Flash მოდელს დიდ მასშტაბზე, მაღალი გამტარუნარიანობითა და დაბალი დაყოვნებით ემსახურება. კომპანია ამბობს, რომ საწარმოო სტეკს იმიტომ აზიარებს, რომ საზოგადოებას გამოთვლითი ხარჯისა და ენერგიის მოხმარების შემცირებაში დაეხმაროს.
ინფერენსი ის ეტაპია, როცა უკვე გაწვრთნილი ხელოვნური ინტელექტი მომხმარებლის მოთხოვნას პასუხობს. ყოველი პასუხი, რომელსაც ჩატბოტი წერს, ინფერენსის შედეგია. ამიტომ ამ ეტაპის ეფექტიანობა პირდაპირ განსაზღვრავს, რა დაჯდება AI სერვისი და რამდენად სწრაფად იმუშავებს.
სარჩევი
რა არის DeepInfer და რას აკეთებს
GitHub-ის ოფიციალური რეპოზიტორიის მიხედვით, DeepInfer არის მაღალი წარმადობის ფრეიმვორკი, რომელიც DeepSeek-ის დიდ საწარმოო სერვისებს ამუშავებს. ღია ვერსია ოფლაინ ინფერენსს უზრუნველყოფს და მასშტაბური მომსახურებისთვის საჭირო ძირითად ფუნქციებს მოიცავს. ამ ეტაპზე ფრეიმვორკი მხოლოდ ერთ მოდელს უჭერს მხარს: DeepSeek-V4.1-Flash-ს. ნაგულისხმევად ის იყენებს DeepSeek-V4.1-Flash-1017 ჩეკპოინტს Hugging Face-იდან, რომელიც პირველი გაშვებისას ავტომატურად ჩამოიტვირთება.
რეპოზიტორიაში ჩამოთვლილია ძირითადი შესაძლებლობები:
- ოპტიმიზებული კერნელები: DeepSeek-ის ადრე გახსნილი ბიბლიოთეკები FlashMLA, DeepGEMM, DeepEP, TileKernels და DeepSelect, ასევე საკუთარი TileLang კერნელები.
- პარალელიზმი: ყურადღების (Attention) მონაცემთა პარალელიზმი და დაბალანსებული კონტექსტური პარალელიზმი, MoE ექსპერტების პარალელიზმი დატვირთვის ბალანსირებით (EPLB).
- DSpark და ნდობაზე დაფუძნებული ვერიფიკაცია: დეკოდირება დრაფტ ტოკენებით ჩქარდება, ნდობის შეფასება კი წყვეტს, როდის შემოწმდეს ისინი. დრაფტის მაქსიმალური სიგრძე ნაგულისხმევად 5 ტოკენია.
- ასინქრონული დაგეგმვა: CPU-ზე პაკეტების დაგეგმვა მოწყობილობაზე გამოთვლის პარალელურად მიმდინარეობს. ეს ფუნქცია ნაგულისხმევად ჩართულია.
- დეტერმინისტული შედეგები: პაკეტის შემადგენლობისგან დამოუკიდებელი ინფერენსი და დეტერმინისტული სემპლინგი, ანუ ერთნაირ შეყვანაზე ერთნაირი პასუხი. ორივე მხოლოდ NVIDIA-ზე მუშაობს.
- სტრუქტურირებული პასუხები: გენერაციის შეზღუდვა regex-ით, JSON სქემით ან EBNF გრამატიკით.
NVIDIA და Huawei Ascend ერთ ფრეიმვორკში
ტექნიკური დეტალებიდან ყველაზე საინტერესო აპარატურის სიაა. DeepInfer ორ პლატფორმაზე მუშაობს: NVIDIA-ს SM100 თაობის GPU-ებზე (Blackwell) და Huawei-ს Ascend 950 NPU-ებზე. ასაწყობად საჭიროა Linux, Python 3.12 და GCC 13 ან უფრო ახალი, NVIDIA-ზე CUDA 13, Ascend-ზე კი CANN 9.2. ჩინური კომპანიისთვის, რომელიც ამერიკული ჩიპების ექსპორტის შეზღუდვების პირობებში მუშაობს, Huawei-ს ჩიპების სრულფასოვანი მხარდაჭერა ღია კოდში მნიშვნელოვანი სიგნალია.
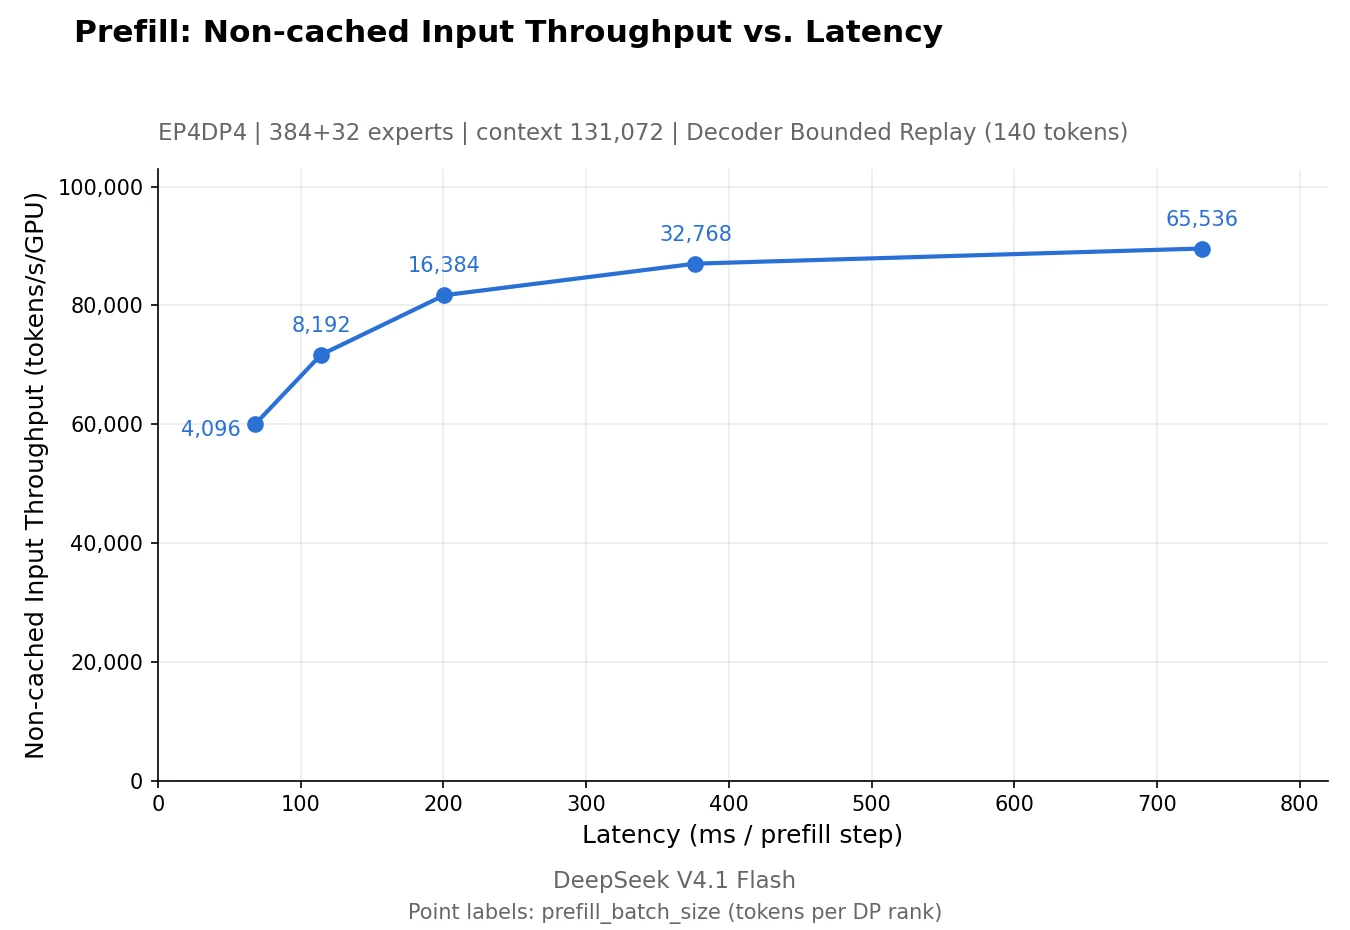
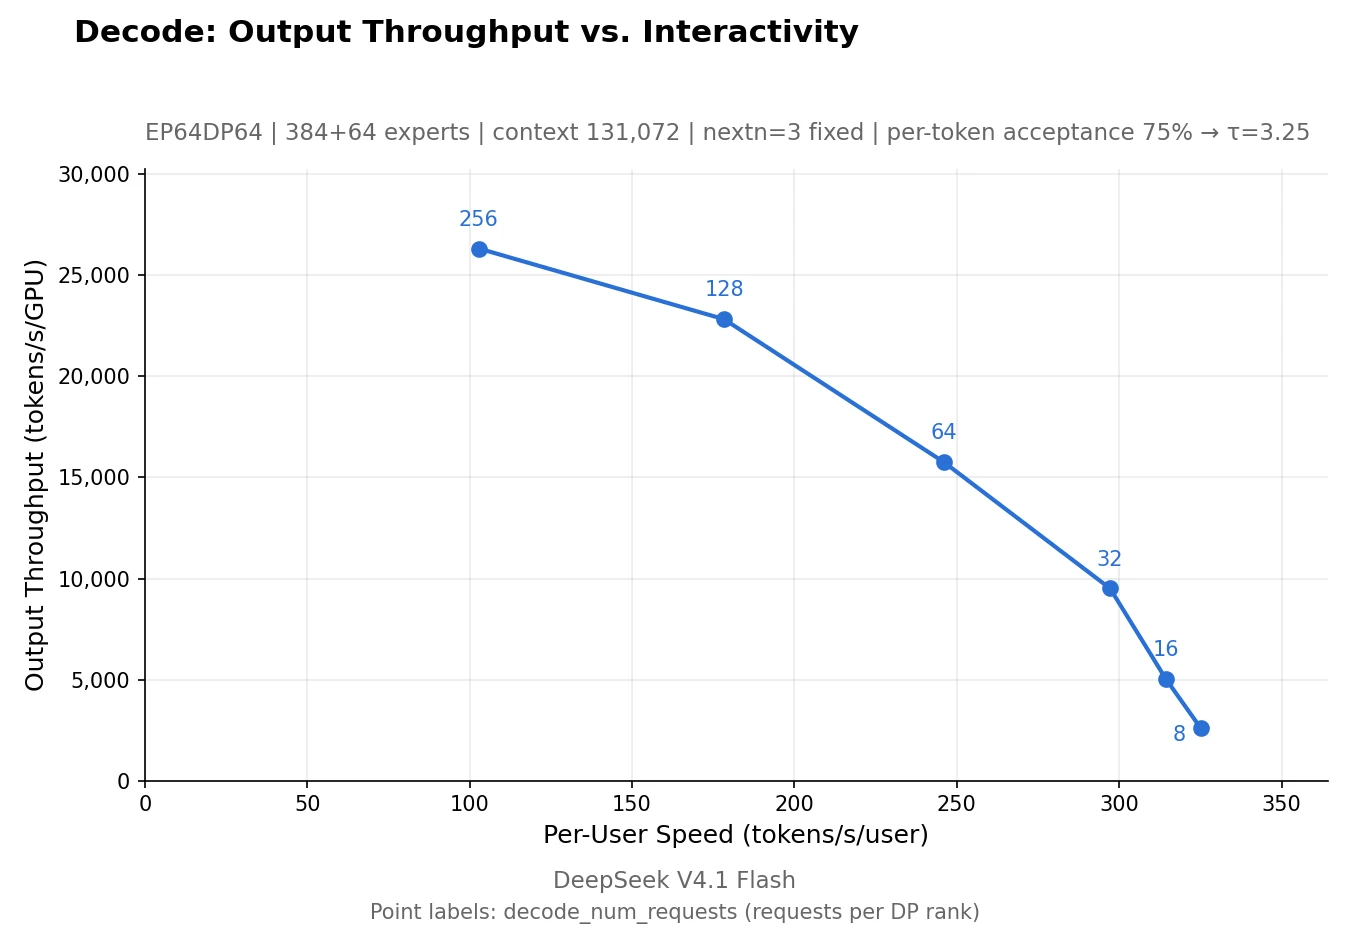
DeepSeek-მა წარმადობის გრაფიკებიც გამოაქვეყნა. ისინი აჩვენებს, როგორ იცვლება გამტარუნარიანობა დაყოვნებასთან და ერთი მომხმარებლის სიჩქარესთან მიმართებაში. კომპანიის თქმით, prefill ეტაპი 4 SM100 GPU-ზე გაიზომა, დეკოდირება კი 64 GPU-ზე, ორივე ერთი scale-up დომენის ფარგლებში. ტესტების გასამეორებელი სკრიპტიც რეპოზიტორიაშია.
რა არ შედის ღია ვერსიაში
DeepSeek პირდაპირ წერს, რომ სრული ინფერენს სერვისისთვის ეს გამოშვება საკმარისი არ არის. მასში არ შედის KV ქეშის სისტემა, VE/Prefill/Decode ეტაპების დაყოფა (თუმცა ძრავის საჭირო ფუნქციების უმეტესობა უკვე რეალიზებულია) და დატვირთვის გადანაწილება მონაცემთა პარალელურ რეპლიკებს შორის. ანუ DeepInfer ჯერ ძრავია და არა მზა, ჩართვისთანავე სამუშაო API სერვერი.
ფრეიმვორკი Apache 2.0 ლიცენზიით ვრცელდება, რაც კომერციულ გამოყენებასაც უშვებს. DeepSeek ასევე აღნიშნავს, რომ DeepInfer თავდაპირველად ძირითადად vLLM-ზე აშენდა, დამატებით კი SGLang-ითა და TensorRT-LLM-ით შთაგონდა.
ვისთვის არის DeepInfer საინტერესო
ჩვეულებრივი მომხმარებლისთვის, რომელიც DeepSeek-ს ჩატში ან API-ით იყენებს, ეს სიახლე პირდაპირ არაფერს ცვლის. DeepInfer პირველ რიგში საინტერესოა ღრუბლოვანი პროვაიდერებისთვის, კვლევითი ლაბორატორიებისა და კომპანიებისთვის, რომლებსაც DeepSeek-V4.1-Flash-ის საკუთარ ინფრასტრუქტურაზე გაშვება სურთ. მათ ახლა შეუძლიათ ნახონ, როგორ ამუშავებს მოდელს თავად მისი შემქმნელი, და ეს გამოცდილება საკუთარ სისტემებში გამოიყენონ. დეტერმინისტული შედეგები კი განსაკუთრებით მნიშვნელოვანია ტესტირებისა და კვლევისთვის, სადაც ერთი და იმავე ექსპერიმენტის ზუსტად გამეორება საჭიროა.
ეს გამოშვება DeepSeek-ის ღია ინფრასტრუქტურის ხაზს აგრძელებს. კომპანიამ ადრე FlashMLA, DeepGEMM და DeepEP გახსნა, ახლა კი მათ ერთ საწარმოო ფრეიმვორკში აერთიანებს. V4.1-Flash-ის ბოლო განახლებაზე ვრცლად შეგიძლიათ წაიკითხოთ ჩვენს სტატიაში DeepSeek V4.1 Flash 1017-ის შესახებ.
შეჯამება
DeepInfer არის DeepSeek-ის საწარმოო ინფერენსის ფრეიმვორკი, რომელიც ახლა Apache 2.0 ლიცენზიით ღიაა. ის DeepSeek-V4.1-Flash-ს ამუშავებს NVIDIA SM100-სა და Huawei Ascend 950-ზე, თუმცა სრული სერვისისთვის საჭირო ზოგიერთი კომპონენტი ჯერ არ შედის.
ეს უფრო საინჟინრო ღირებულების გამოშვებაა, ვიდრე ფართო აუდიტორიისთვის განკუთვნილი ინსტრუმენტი. ის მხოლოდ ერთ მოდელს და უახლეს აპარატურას უჭერს მხარს, ამიტომ მცირე გუნდებისთვის მისი პირდაპირ გამოყენება რთული იქნება. სამაგიეროდ, ღიად გამოქვეყნებული საწარმოო სტეკი და Huawei-ს ჩიპების მხარდაჭერა აჩვენებს, რომ DeepSeek-ის სტრატეგია მოდელების გარდა იაფ და გამჭვირვალე ინფრასტრუქტურასაც მოიცავს. დამოუკიდებელი ტესტები ჯერ არ გამოქვეყნებულა, ამიტომ წარმადობის მონაცემები ამ ეტაპზე კომპანიის საკუთარ გაზომვებს ეფუძნება.
სხვა თემები
 MiniMax M3.1 Flash: Space Bunny ჩინური MiniMax-ის ახალი მოდელი აღმოჩნდა
 Nemotron 3.5 Super VL: NVIDIA-ს ახალი ღია მოდელები აგენტებისთვის
 NVIDIA RTX Spark: AI ლეპტოპები Windows-ისთვის უკვე იყიდება