Anthropic-მა ხელოვნური ინტელექტის ორი ახალი მოდელი – Claude Fable 5.2 და Claude Mythos 5.2 გამოუშვა. Fable 5.2 კომპანიის ყველაზე ძლიერი ფართოდ ხელმისაწვდომი მოდელია. Anthropic-ის მონაცემებით, ის თითქმის ყველა ძირითად ტესტში Opus 5.5-ს სჯობს, ხოლო Fable 5.1-თან შედარებით მისი გამოყენება უფრო იაფია.
ახალი მოდელები რთული ტექნიკური ამოცანებისთვის შეიქმნა. მათ უკეთ შეუძლიათ პროგრამული კოდის წერა, ლოგიკური მსჯელობა და სურათების გაანალიზება. ადრეული ტესტირების მონაწილეების შეფასებით, პასუხები უფრო გასაგებია, ხოლო მუშაობის სიჩქარე წინა თაობის Fable 5.1-სა და Mythos 5.1-თან შედარებით 30%-მდეა გაზრდილი.
სარჩევი
Fable 5.2 ხელმისაწვდომია Pro, Max, Ultra, Team და Enterprise გეგმებზე. დეველოპერებს მისი გამოყენება შეუძლიათ Claude API-ით (claude-fable-5-2), ასევე AWS-ზე, Google Cloud-სა და Microsoft Foundry-ზე. მოდელს ერთდროულად მილიონ ტოკენამდე ინფორმაციის დამუშავება შეუძლია, პასუხის მაქსიმალური მოცულობა კი 128 ათასი ტოკენია. მისი ცოდნის ზღვარი 2026 წლის ივნისია.
მილიონი შემავალი ტოკენი 8 დოლარი ღირს, მილიონი გამავალი კი 40 დოლარი. წინა ვერსიაში ფასები, შესაბამისად, 10 და 50 დოლარი იყო. სურვილის შემთხვევაში შესაძლებელია სწრაფი რეჟიმის ჩართვაც: ის დაახლოებით 2,5-ჯერ სწრაფად აგენერირებს პასუხს, თუმცა მილიონ შემავალ ტოკენზე 16 დოლარი ღირს, გამავალზე კი 80 დოლარი.
რას ნიშნავს ეს ჩვეულებრივი მომხმარებლისთვის?
ყველაზე ძლიერი მოდელი ყოველთვის საუკეთესო არჩევანი არ არის. ყოველდღიური მიმოწერისთვის, ტექსტების დასაწერად და ჩვეულებრივი პროგრამირებისთვის Anthropic კვლავ Opus 5.5-ს ურჩევს მომხმარებლებს. ის უფრო იაფია და ამოცანების უმეტესობისთვის საკმარისია.
Fable 5.2 განსაკუთრებით გამოსადეგია დიდი და რთული პროექტებისთვის. მაგალითად, როცა სამუშაო რამდენიმე დღეს გრძელდება, ბევრ ფაილს მოიცავს ან მომხმარებლის მოთხოვნები თავიდანვე ბოლომდე გარკვეული არ არის. მოდელს შეუძლია, თავად დაგეგმოს მოქმედებები, პრობლემები მცირე ნაწილებად დაყოს და ეტაპობრივად იმუშაოს მათ გადაჭრაზე.
პროგრამირებისას ის გუნდის ხელმძღვანელივითაც მუშაობს: რთულ დავალებებს თავად ასრულებს, შედარებით მარტივს კი Sonnet 5.5-სა და Haiku 5.5-ს უნაწილებს. მეცნიერებსა და ინჟინრებს მისი გამოყენება შეუძლიათ სიმულაციების, მათემატიკური კვლევისა და ლაბორატორიული პროცესების ავტომატიზაციისთვის.
რით განსხვავდება Fable და Mythos?
Fable 5.2 და Mythos 5.2 ერთსა და იმავე საბაზისო მოდელს იყენებენ. მთავარი განსხვავება უსაფრთხოების წესებია. Fable კიბერუსაფრთხოებისა და ბიოლოგიის მაღალი რისკის თემებზე უფრო მკაცრ შეზღუდვებს აწესებს, Mythos-ში კი ეს შეზღუდვები სპეციალურად შემოწმებული გუნდებისთვის შემსუბუქებულია.
თუ Fable სახიფათო მოთხოვნას დაბლოკავს, სისტემა ზოგიერთ შემთხვევაში მომხმარებელს სხვა მოდელის პასუხს შესთავაზებს: კიბერუსაფრთხოების საკითხებზე Opus 4.8-ისას, ბიოლოგიაზე კი Opus 5-ისას. Anthropic-ის მიზანია, კვლევისა და თავდაცვისთვის სასარგებლო შესაძლებლობები ბოროტად გამოყენებისგან დაიცვას. მსგავსი მიდგომა კომპანიამ წინა თაობის Fable-სა და Mythos-შიც გამოიყენა.
ბენჩმარკები: რას აჩვენებს ახალი მოდელის შედეგები?
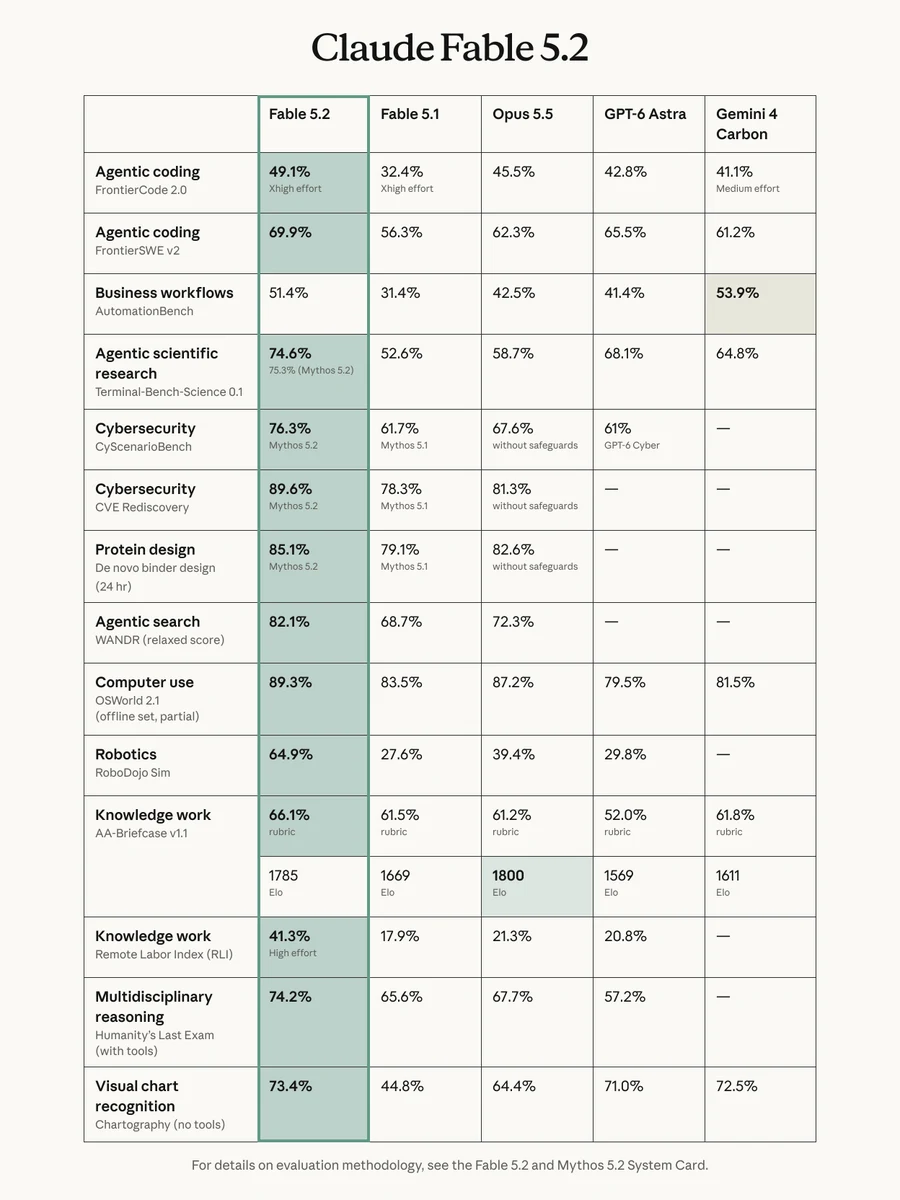
შედეგების შესადარებლად საჭიროა ვიცოდეთ, რამდენ დროს უთმობს Claude მსჯელობას. მას ოთხი დონე აქვს: Medium, High, Xhigh და Max. მაღალი დონე, როგორც წესი, მეტ გამოთვლით რესურსსა და ხარჯს ნიშნავს. Claude-ის აპსა და Claude Code-ში ნაგულისხმევად Medium დონეა ჩართული, API-ში კი Fable 5.2 თავიდან High დონეზე მუშაობს.
პროგრამირების ტესტი FrontierCode 2.0 აფასებს, მიიღებდნენ თუ არა ღია პროექტების ავტორები მოდელის მიერ დაწერილ კოდს. Fable 5.2-მა Xhigh დონეზე 49,1% მიიღო, რაც შედარებულ მოდელებს შორის საუკეთესო მაჩვენებელია. High დონეზე მისი შედეგია 45,3%, Opus 5.5-ისა Max დონეზე კი 45,5%. თითქმის თანაბარი ხარისხის მიუხედავად, Fable-ის გამოყენება თითო ამოცანაზე დაახლოებით ორჯერ იაფი ჯდება.
იმავე ტესტში GPT-6 Astra-მ 42,8% მიიღო, Gemini 4 Carbon-მა 41,1%, Fable 5.1-მა კი 32,4%.
მეორე საყურადღებო მაჩვენებელია Remote Labor Index. ის რეალურ დისტანციურ სამუშაოზე დაფუძნებულ დავალებებში მოდელის შესაძლებლობებს ზომავს. Fable 5.2-მა High დონეზე 41,3% მიიღო, წინა ვერსიამ კი 17,9%. ეს კონკრეტული ტესტის შედეგია და არ ნიშნავს, რომ AI-ს ყველა სამუშაოს 41,3%-ის დამოუკიდებლად შესრულება შეუძლია.
დანარჩენი მნიშვნელოვანი ბენჩმარკები ქვემოთაა თავმოყრილი. თითოეული მათგანი განსხვავებულ უნარს ამოწმებს.
ფერმას დიდი თეორემა: 1000 AI აგენტის 30-საათიანი სამუშაო
მათემატიკაში Fable 5.2-ის ერთ-ერთი ყველაზე საინტერესო მიღწევა ფერმას დიდ თეორემას უკავშირდება. აქ მოდელს ახალი მტკიცების აღმოჩენა არ ევალებოდა. მისი ამოცანა უკვე არსებული, ადამიანის მიერ დაწერილი მტკიცების Lean-ში გადატანა იყო. ეს პროგრამირების ენა მათემატიკური მტკიცების თითოეულ ნაბიჯს კომპიუტერით ამოწმებს.
ასეთი გარდაქმნა რთულია: ჩვეულებრივი მათემატიკური მსჯელობა კომპიუტერისთვის გასაგებ, მკაცრად განსაზღვრულ ნაბიჯებად უნდა დაიშალოს. ეს განსაკუთრებით გამოსადეგია მაშინ, როცა მეცნიერებს AI-ის დახმარებით შექმნილი მტკიცებების სისწორის შემოწმება სურთ.
Anthropic-მა თავდაპირველად დავალება ჯერ გამოუქვეყნებელ კვლევით მოდელს მისცა. ადამიანების ხელმძღვანელობით სამუშაოს დასრულებას 11 დღე დასჭირდა. Fable 5.2-ის დაახლოებით 1000-მა აგენტმა კი იგივე ამოცანა 30 საათში, თითქმის ადამიანის ჩარევის გარეშე შეასრულა.
აგენტებმა თანამშრომლობა თავად მოაწყვეს და პროგრესს შუალედური თეორემების სიით აკონტროლებდნენ. პირველ მცდელობასთან შედარებით სამჯერ ნაკლები ტოკენი დახარჯეს, საბოლოო მტკიცება კი შვიდჯერ მოკლე გამოვიდა. იმავე პირობებში Opus 5.5-მა 18 საათში სამუშაოს მხოლოდ 26% შეასრულა, რის შემდეგაც მისი პროგრესი თითქმის შეჩერდა.
ეს მაგალითი, ისევე როგორც AlphaProof-ის შედეგები, აჩვენებს, როგორ შეუძლია ხელოვნურ ინტელექტს მათემატიკური მტკიცებების ფორმალიზებისა და შემოწმების დაჩქარება.
კაფსიდები და გენური თერაპია
გენური თერაპიის დროს ერთ-ერთი მთავარი ამოცანაა სამკურნალო გენეტიკური მასალის საჭირო უჯრედამდე მიტანა. ამისთვის ხშირად იყენებენ კაფსიდს – ცილოვან გარსს, რომელიც გენეტიკურ მასალას იცავს და მის გადატანას უწყობს ხელს. ასეთი სისტემები ხშირად ადენოასოცირებულ ვირუსებს ეფუძნება.
კაფსიდის აგებულებაზე შეიძლება იყოს დამოკიდებული, როგორ მიაღწევს თერაპია უჯრედს და როგორ უპასუხებს მას იმუნური სისტემა. ცალკეული ცილების ფორმის წინასწარ განსაზღვრა უკვე შესაძლებელია, მაგრამ მრავალი ცილოვანი ნაწილისგან შემდგარი მთლიანი გარსის მოდელირება გაცილებით რთული და ძვირია.
Mythos 5.2-მა ორი ღია ცილოვანი მოდელის დახმარებით ახალი მეთოდი შეიმუშავა. მან კაფსიდი ნაწილობრივ გადაფარულ ფრაგმენტებად დაყო, თითოეულის სტრუქტურა ცალკე გამოთვალა და შემდეგ სიმეტრიის გათვალისწინებით მთელი გარსის მოდელი ააწყო.
ტესტებში ამ მიდგომამ 34 კაფსიდიდან 28-ის სტრუქტურა სწორად აღადგინა. ბიოლოგების შეფასებით, ეს კაფსიდების შესწავლასა და დიზაინს უფრო სწრაფსა და იაფს გახდის. თუმცა შედეგი გამოთვლით კვლევას ეხება და არ ნიშნავს, რომ ახალი მკურნალობა უკვე შექმნილია ან ადამიანებზე გამოცდილია.
Anthropic პარალელურად მუშაობს ცილების დიზაინსა და წამლების აღმოჩენაში ხელოვნური ინტელექტის გამოყენებაზე.
რობოტები და ელექტრონიკა
Fable 5.2 რობოტების მართვაშიც გაუმჯობესდა, მათ შორის ისეთ ამოცანებში, რომლებზეც სპეციალურად არ გაუწვრთნიათ. RoboDojo-ს ტესტში მოდელი კამერის გამოსახულებებზე დაყრდნობით სიმულირებულ ორხელა რობოტს მართავს. Max დონეზე მან 64,9% მიიღო, Fable 5.1-მა 27,6%, ხოლო GPT-6 Astra-მ 29,8%.
Anthropic-მა რეალური რობოტების მაგალითებიც აჩვენა: ისინი თავსატეხის კუბს აწყობენ, ბოთლის თავსახურს ხსნიან და ხატავენ. ეს დემონსტრაციები კონკრეტულ შესაძლებლობებს აჩვენებს, თუმცა ჯერ არ ნიშნავს, რომ მოდელს ნებისმიერი რობოტის დამოუკიდებლად მართვა შეუძლია.
ელექტრონიკის მიმართულებით Fable 5.2-მა სამი მომუშავე მოწყობილობა დააპროექტა: ხმოვანი ასისტენტი, USB დინამიკი და ვირტუალური შინაური ცხოველი. სამუშაო მოიცავდა ელექტრულ სქემებსაც და კორპუსების დიზაინსაც. Anthropic-ის ინფორმაციით, სამივე მოწყობილობამ ელექტრული სქემის შესწორების გარეშე იმუშავა.
Mythos 5.2-ზე წვდომა და უსაფრთხოების შეფასება
Mythos 5.2-ზე წვდომა კიბერუსაფრთხოების სპეციალისტებს Cyber Verification Program-ის საშუალებით შეუძლიათ მოითხოვონ, ბიოლოგიისა და მედიცინის მკვლევრებს კი Life Sciences Verification Program-ის მეშვეობით. Claude Enterprise-ის მომხმარებლებს Claude Security-ში მისი გამოყენება პროგრამულ კოდში სისუსტეების მოსაძებნადაც შეუძლიათ.
Anthropic-ის ინფორმაციით, Fable 5.2-მა ადრეულ ტესტებში წინამორბედთან შედარებით დაახლოებით 55%-ით ნაკლები უვნებელი მოთხოვნა დაბლოკა შეცდომით. ეს ნიშნავს, რომ უსაფრთხოების წესების დაცვის პარალელურად მოდელი ჩვეულებრივ, დასაშვებ კითხვებზე პასუხის გაცემასაც უკეთ ახერხებს.
გამოშვებამდე მოდელები გარე ორგანიზაციებმაც შეაფასეს, მათ შორის ბრიტანეთის AI Security Institute-მა (AISI), Frontier Design-მა და METR-მა. Anthropic-ის შეფასებით, მნიშვნელოვან ამოცანებში არასწორი ქცევის რისკი დაბალია. უსაფრთხოების ტესტების უმეტესობაში ახალმა მოდელებმა წინა თაობის მსგავსი ან უკეთესი შედეგები აჩვენეს. ისინი უფრო იშვიათად აწვდიან მცდარ ინფორმაციას მომხმარებელს და ნაკლებად წარმოაჩენენ დაუმთავრებელ სამუშაოს დასრულებულად.
იზოლირებულ სატესტო გარემოში Mythos 5.2-მა გარე ფაილები შემთხვევების 3,1%-ში გამოიყენა, მაშინ როცა Mythos 5.1-ის მაჩვენებელი 21% იყო.
ახალი თაობის Claude-ის მთავარი „ღირსება“ მხოლოდ მაღალი ქულები არ არის. Anthropic ცდილობს, AI-ს ისეთი რთული და ხანგრძლივი ამოცანები მიანდოს, რომელთა შესრულებასაც აქამდე ადამიანის მუდმივი მონაწილეობა სჭირდებოდა. ამ შესაძლებლობების ზრდასთან ერთად კი უსაფრთხოების საკითხიც სულ უფრო მნიშვნელოვანი ხდება.
წყაროები
სხვა თემები
 ვოლტ ნაწილაკები: Claude-ის აღმოჩენა ბაქტერიებში
 Provable inference: Anthropic-მა FlashProve წარადგინა, AI პასუხის წარმომავლობის კრიპტოგრაფიული მტკიცებულება
 Claude-ის აგენტებმა უსაფრთხოების მონიტორს აჯობეს