Provable inference, ანუ „დამტკიცებადი ინფერენსი“, ის მიმართულებაა, რომელზეც Anthropic-ის Frontier Red Team-მა EPFL-ის, MIT-ისა და სხვა ორგანიზაციების მკვლევრებთან ერთად იმუშავა. 2 ნოემბერს გამოქვეყნებულ კვლევით პოსტში მათ FlashProve წარადგინეს. ეს ღია კოდის პროტოტიპია, რომელიც დიდი ენობრივი მოდელის ყოველ პასუხზე კრიპტოგრაფიულ მტკიცებულებას ქმნის: პასუხი მართლაც იმ მოდელმა დააგენერირა, რომელსაც კომპანია ასახელებს.
Anthropic თავად წერს, რომ ეს შუალედური პროგრესია და არა დასრულებული კვლევა. სისტემა საჯარო Llama 4 Maverick მოდელზე გამოსცადეს.
სარჩევი
Provable inference-ის მიზანი ისაა, რომ მომხმარებელმა, რომელსაც არც მოდელის წონები აქვს და არც ძლიერი კომპიუტერი, შეძლოს შეამოწმოს, რომ პასუხი მართლაც მოთხოვნილმა მოდელმა დააგენერირა.
რა პრობლემას წყვეტს provable inference
როცა ჩატბოტს ვწერთ, ვერ შევამოწმებთ, რომ პასუხი მართლაც არჩეულმა მოდელმა დაწერა. შუამავალმა სერვისმა შეიძლება ხარჯის დასაზოგად იაფი მოდელი ჩაანაცვლოს, ჰაკერმა კი სერვერი გატეხოს და პასუხები შეცვალოს. მხოლოდ ტექსტის ხარისხით ამის გარკვევა შეუძლებელია. მოდელის ხელახლა გაშვებით შემოწმებაც არ გამოდის: წამყვანი მოდელების წონები, ანუ ის მილიარდობით რიცხვი, რომელიც მოდელის „ცოდნას“ ინახავს, საიდუმლოა, თანაც მათ გასაშვებად ძვირადღირებული აპარატურა სჭირდება.
Provable inference-ისთვის ავტორები zkSNARK-ს იყენებენ. ეს კრიპტოგრაფიული მტკიცებულების სახეობაა: მოკლე „სერტიფიკატი“, რომლითაც ერთი მხარე მეორეს არწმუნებს, რომ გამოთვლა სწორად შესრულდა. „Zero-knowledge“ ნიშნავს, რომ სერტიფიკატი არაფერს ამხელს იმის გარდა, რომ გამოთვლა სწორია. „Succinct“ კი იმას, რომ მისი შემოწმება ბევრად სწრაფია, ვიდრე თავად გამოთვლის გამეორება.
როგორ მუშაობს provable inference FlashProve-ში
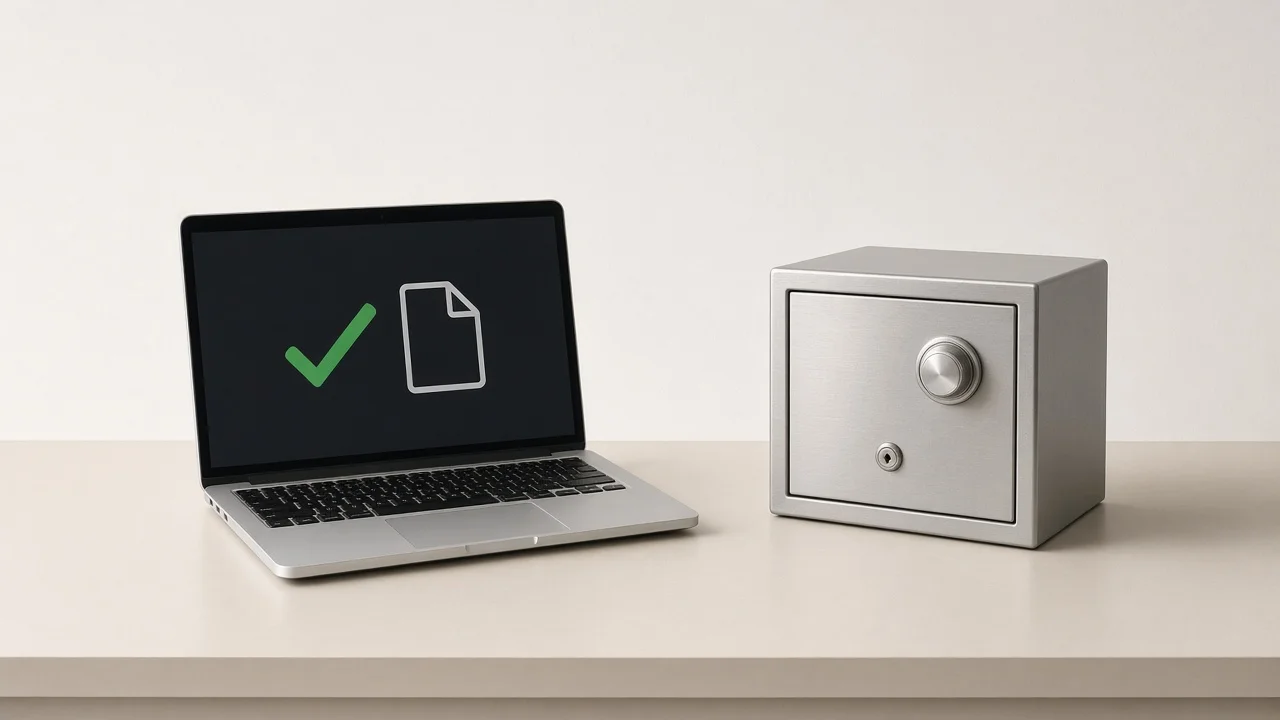
სისტემაში ორი მხარეა: მოდელის მომწოდებელი, რომელიც მტკიცებულებას ქმნის, და მომხმარებელი, რომელიც მას ამოწმებს. ჯერ მომწოდებელი აქვეყნებს წონების „ვალდებულებას“ (commitment). ეს მოკლე ციფრული ანაბეჭდია, რომელიც წონების ერთ კონკრეტულ ნაკრებს აფიქსირებს, თავად წონებს კი არ აჩენს. შემდეგ ყოველ მოთხოვნაზე მომწოდებელი ქმნის ფაილს, რომელიც ამტკიცებს: სწორედ ამ წონებმა, ამ მოთხოვნაზე, ზუსტად ეს ტოკენები დააგენერირა.
ავტორების თქმით, ყალბი მტკიცებულების შექმნა პრაქტიკულად შეუძლებელია, თუ ფართოდ აღიარებული კრიპტოგრაფიული დაშვებები არ დაირღვა. მტკიცებულება არც წონებს ამხელს და არც იმას, მოდელის რომელი „ექსპერტები“ ჩაერთო. მოდელის არქიტექტურა კი არ იმალება.
ციფრები
ტესტისთვის Meta-ს Llama 4 Maverick გამოიყენეს. ეს 400 მილიარდპარამეტრიანი Mixture-of-Experts მოდელია, რომელიც ყოველ ტოკენზე დაახლოებით 17 მილიარდ პარამეტრს იყენებს. ტესტში მისი საჯარო 4-ბიტიანი ვერსია გამოიყენეს. ერთმა H100 GPU-მ მტკიცებულებები დაახლოებით 110 ტოკენი/წამში შექმნა. 1 024-ტოკენიან მოთხოვნაზე მტკიცებულების ზომა დაახლოებით 19 MB-ია, ხოლო მის შემოწმებას ჩვეულებრივ 24-ბირთვიან პროცესორზე 17 წამი სჭირდება. GPU საჭირო არ არის. წონების ვალდებულების შექმნა ერთხელ ხდება და დაახლოებით 39 წუთი გრძელდება.
მტკიცებულების შექმნა მაინც ძვირია: GPU-ს დრო დაახლოებით 70–95-ჯერ მეტია, ვიდრე vLLM-ში იმავე მოთხოვნების ჩვეულებრივ დამუშავებას სჭირდება. თუმცა წინა ღია სისტემებთან შედარებით ეს დიდი ნახტომია. მაგალითად, VerInf-მა იგივე მოდელი დაახლოებით 0,02 ტოკენი/წამში დაამტკიცა: 1 000 ტოკენზე 14,3 საათი დასჭირდა, მტკიცებულება კი 93,6 GB იყო.
Claude-ის როლი და ფორმალური შემოწმება
Anthropic-ის თქმით, სისტემის გაუმჯობესების დიდი ნაწილი Claude-მა შეიმუშავა, პროტოკოლის სპეციფიკაციაც მან დაწერა. Claude კვლევით ამოცანებში ადრეც გამოუყენებიათ: მაგალითად, მან 3-SAT-ის ახალი ალგორითმი იპოვა. ავტორები აღიარებენ, რომ Claude-ის გადაწყვეტილებების შეფასება რთულ სისტემებში ძნელია. ამიტომ უსაფრთხოების მთავარი გარანტიები Lean-ში, მათემატიკური მტკიცებულებების ავტომატური შემოწმების ენაში, ჩამოაყალიბეს და დაამტკიცეს. გამოქვეყნდა კოდი Apache 2.0 ლიცენზიით: მტკიცებულების შემქმნელი, სწრაფი C++ შემმოწმებელი და ნელი, მაგრამ Lean-ით დამტკიცებული შემმოწმებელი.
სად შეიძლება გამოდგეს provable inference
ავტორები რამდენიმე სცენარს ასახელებენ. დამოუკიდებელ შემფასებლებს სჭირდებათ იმის ცოდნა, რომ ზუსტად იმ მოდელს ამოწმებენ, რომელიც მომხმარებლებს ემსახურება. კომპანიას შეუძლია ყოველ პასუხზე მტკიცებულება მოითხოვოს, რომ გატეხილ სერვერზე მოდელის ჩანაცვლება შეამჩნიოს. მომავალში რეგულატორებსაც შეეძლებათ შეამოწმონ, რომ მომწოდებელი მხოლოდ დამტკიცებულ მოდელებს იყენებს. ეს თემა AI-ის უსაფრთხოებისა და მონიტორინგის საკითხებს უკავშირდება, რომლებზეც llm.ge ადრეც წერდა. Anthropic აღნიშნავს, რომ საკუთარი ტრაფიკის შემოწმების მიზანი სხვა, დაკავშირებული პროექტით შეასრულა. ეს პროექტი პასუხებს ხელს აწერს და სანდო სერვერზე ხელახლა ითვლის. FlashProve იმავე მიზანს სხვა გზით, provable inference-ის კრიპტოგრაფიული მეთოდით ემსახურება.
Provable inference-ის შეზღუდვები
FlashProve კვლევითი პროტოტიპია და მას რამდენიმე მნიშვნელოვანი შეზღუდვა აქვს:
- სწრაფ C++ კოდს ფორმალური გარანტია არ აქვს. ავტორები არ იძლევიან გარანტიას, რომ Lean-ის ვერსია, ტექნიკური ანგარიში და კოდი ერთმანეთს ზუსტად ემთხვევა.
- მტკიცებულება მოდელის მთელი რიცხვების ვერსიას და ხარბ (greedy) დეკოდირებას ეხება. ჩვეულებრივი, ათწილადებით გაშვებული ან შემთხვევითი არჩევით (sampling) მიღებული პასუხი შეიძლება ზუსტად არ დაემთხვეს.
- სისტემა მხოლოდ Mixture-of-Experts მოდელებზეა მორგებული და არქიტექტურას არ მალავს.
- კონტექსტი 1 024 ტოკენით შემოიფარგლება, ეს კი თანამედროვე ჩატებისთვის ძალიან ცოტაა.
- მტკიცებულება ერთხელ შექმნილ ტექსტს ამოწმებს, ანუ მოგვიანებით (post-hoc) და არა პასუხის გენერაციისას.
- „გვერდითი არხებით“ შეტევები, მაგალითად მტკიცებულების შექმნის დროის გაზომვა, ამ ვერსიაში განხილული არ არის.
მიუხედავად ამისა, provable inference-ის მიმართულებით პროგრესი შთამბეჭდავია: რამდენიმე წლის წინ ასეთი მტკიცებულებები მცირე მოდელებზეც საათობით იქმნებოდა. Anthropic მასალას იმ იმედით აქვეყნებს, რომ სხვები მას შეამოწმებენ და განავითარებენ.
წყაროები
სხვა თემები
 Weight-Space Programming: GPT-6 Astra ნეირონული ქსელების წონებს პირდაპირ წერს
 OpenAI-მ LifeVal წარადგინა: შეფასების სისტემა
 Claude-ის აგენტებმა უსაფრთხოების მონიტორს აჯობეს