Weight-Space Programming-ი MIT CSAIL-ის მკვლევრების ახალი ექსპერიმენტია: დიდი ენობრივი მოდელი სხვა ნეირონული ქსელის წონებს პირდაპირ კითხულობს, ასწორებს და ნულიდანაც წერს, ისე, რომ ამ ქსელს არ ავარჯიშებს. ექსპერიმენტებში OpenAI-ის GPT-6 Astra გამოიყენეს. შედეგები კვლევით ბლოგპოსტშია აღწერილი, რომლის ავტორებიც რიკია ტაკეჰი, ჯეიდენ ტეო, ალექს ჟანგი და ომარ ხატაბი არიან.
ავტორები წერენ, რომ შედეგები „ძალიან ადრეულია“, ხოლო მოდელის შესაძლებლობები „საინტერესო, მაგრამ ჯერ კიდევ შეზღუდულია“.
სარჩევი
რას ნიშნავს Weight-Space Programming
ჩვეულებრივ ნეირონული ქსელის წონები ვარჯიშით, ანუ გრადიენტული დაშვებით ან გამაგრებით სწავლებით (RL), იქმნება. ამ შემთხვევაში კი ენობრივი მოდელი წონებს რიცხვებად ხედავს და მათთან პროგრამის კოდივით მუშაობს. მკვლევრებმა სამი ამოცანა შეამოწმეს: წაკითხვა, ანუ რას აკეთებს ქსელი; შესწორება, ანუ გაფუჭებული ქსელის გამართვა; და დაწერა, ანუ მუშა ქსელის შექმნა ნულიდან.
წაკითხვა: თამაშები, ფორმები და ენები
პატარა ქსელებში, რომლებიც 17 253 წონისგან შედგებოდა, Astra-მ ოთხივე თამაში სწორად ამოიცნო, თუმცა თამაშების სია წინასწარ არ მიუწოდებიათ. 23 824 წონიან დიფუზიურ (DDPM) მოდელებში მან ის ფორმები დახატა, რომლებსაც ეს მოდელები ქმნიან. სიმბოლოების დონის ენობრივ მოდელებში, რომლებიც 7,16 მილიონ წონას შეიცავდნენ, Astra-მ მხოლოდ შუა ბლოკებით ყველა ცდაში სწორად თქვა, რომელ ენაზე იყო მოდელი გაწვრთნილი. მან ზუსტად იპოვა ტექსტის კოპირებაზე პასუხისმგებელი ყურადღების „თავებიც“.
შესწორება: 3,5% წონებისა და სრული შედეგი
Kinetix-ის ფიზიკურ გარემოში 171 664 წონიანი ქსელი ამოცანას ვერ ასრულებდა. Astra-მ ინსტრუმენტების გარეშე, ერთი მცდელობით, წონების დაახლოებით 3,5% შეცვალა. წარმატება 0-დან 1 024/1 024-მდე გაიზარდა. შედარებისთვის, PPO-ით დამატებითმა ვარჯიშმა 256 ცდიდან ვერცერთი ვერ გადაჭრა.
ნულიდან დაწერა: MinAtar და Go
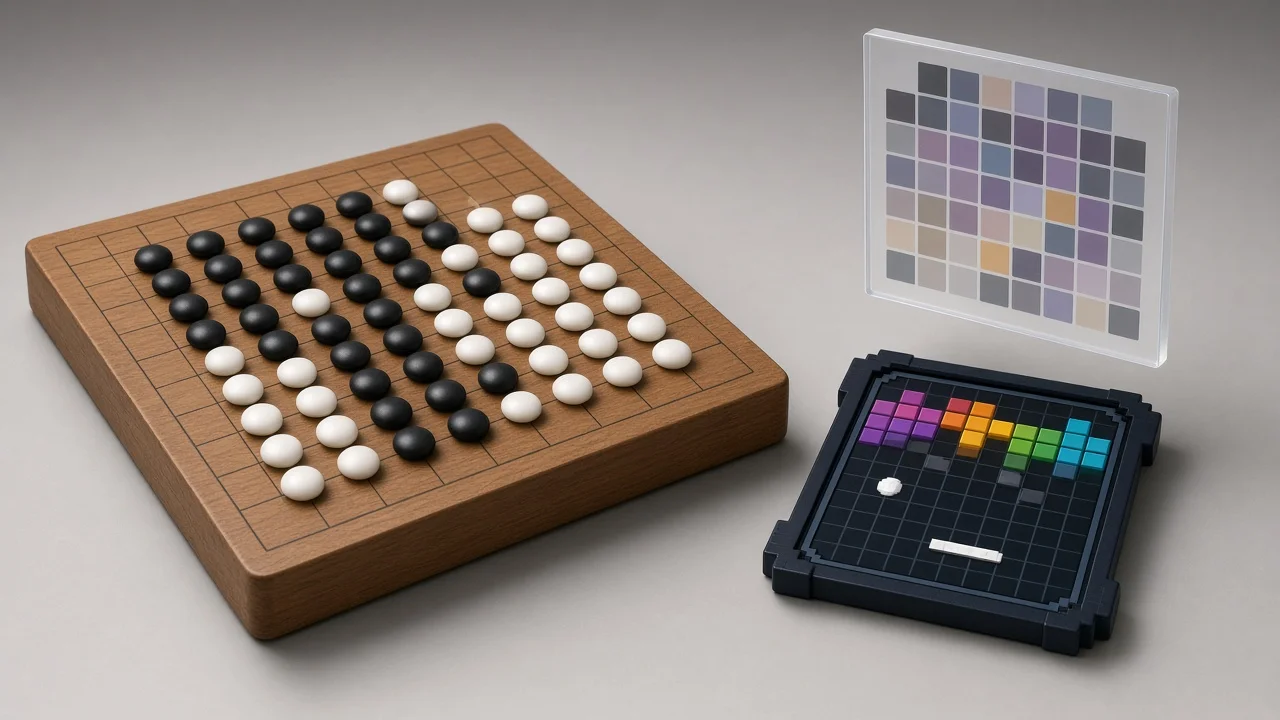
MinAtar-ის თამაშებში Astra-ს მიერ დაწერილმა ქსელებმა 100 მილიონ ნაბიჯზე გაწვრთნილ PPO-ს აჯობეს: Breakout-ში 517,4 ქულა 15,8-ის წინააღმდეგ, Seaquest-ში 53,1 5,6-ის წინააღმდეგ, Asterix-ში 53,2 25,8-ის წინააღმდეგ. 500 მილიონ ნაბიჯზე გაწვრთნილი PPO-ს შედეგები კი Breakout-ში 25,3, Seaquest-ში 88,9 და Asterix-ში 55,2 იყო, ანუ Seaquest-სა და Asterix-ში უფრო ხანგრძლივად გაწვრთნილი PPO წინ არის.
9×9 Go-სთვის Astra-მ 1 480 274 წონიანი ქსელი დაწერა. ქსელის გაშვების გარეშე, ანუ ნულოვანი forward pass-ით, ის პატარა PPO ქსელებთან თამაშების ნახევარზე მეტს იგებდა. 50 forward pass-ის შემდეგ კი მან იმავე ზომის PPO ქსელს აჯობა, რომელიც 20 მილიონ თამაშზე იყო გაწვრთნილი.
მლიქვნელობის აღმოჩენა Gemma-ში
Gemma 3 270M-ის წყვილებში Astra-ს უნდა გაერკვია, რომელი ვერსია იყო გაწვრთნილი მლიქვნელობაზე (sycophancy), ანუ მომხმარებლისთვის თავის დაქნევაზე. მხოლოდ წონებით ოთხივე მცდელობა წარუმატებელი აღმოჩნდა. როცა მას ყურადღების პატერნებიც მისცეს, სამივე წყვილში სწორი მოდელი აირჩია.
Qwen3.5-0.8B: ჩაციკვლა და მათემატიკა
ყველაზე საინტერესო შედეგი Qwen3.5-0.8B-ს ეხება. ეს მოდელი ხშირად ჩაციკლული მსჯელობით ტოკენების ლიმიტს ამოწურავდა. Astra-მ მე-15 და მე-19 ფენებში 131 072 წონა, ანუ მოდელის დაახლოებით 0,016%, შეცვალა და 50 forward pass გამოიყენა. MATH-500-ზე შედეგი 7,9%-დან 48,1%-მდე გაიზარდა, GSM8K-ზე 13,8%-დან 67,1%-მდე, IFEval-ზე კი 21,0%-დან 62,3%-მდე. ლიმიტამდე მისული პასუხების წილი 93%-დან 33,1%-მდე შემცირდა. ცვლილებების ლოგები GitHub-ზეა გამოქვეყნებული, შესწორებული მოდელი კი Hugging Face-ზე.
Gemma-ზე იგივე მიდგომა არ ამუშავდა: MATH-500-ის შედეგი 6,8–7,7%-ის ფარგლებში დარჩა. ავტორების დასკვნით, წონების შეცვლას შეუძლია მოაშოროს დაბრკოლება, რომელიც მოდელის უკვე არსებულ უნარს მალავს, მაგრამ ახალ უნარს ვერ ამატებს.
რატომ არის ეს მნიშვნელოვანი
ნეირონული ქსელები ხშირად „შავ ყუთად“ მიიჩნევა: ვიცით, რა შედის და რა გამოდის, მაგრამ ძნელია იმის გაგება, თუ რა ხდება შიგნით. ინტერპრეტაციის ჩვეულებრივი მეთოდები სპეციალურ ინსტრუმენტებსა და ბევრ ხელით შრომას მოითხოვს. Weight-Space Programming-ის იდეა ისაა, რომ ამ სამუშაოს ნაწილი ენობრივმა მოდელმა თავად შეასრულოს: წაიკითხოს წონები, ახსნას, რას აკეთებს ქსელი, და საჭიროების შემთხვევაში პირდაპირ შეასწოროს ისინი. ეს განსაკუთრებით საინტერესოა უსაფრთხოების თვალსაზრისით, მაგალითად, როცა საჭიროა გაირკვეს, ხომ არ აქვს მოდელს დამალული არასასურველი ქცევა, როგორიცაა მლიქვნელობა. ამავე დროს, ექსპერიმენტები აჩვენებს, რომ მხოლოდ რიცხვების ყურება ყოველთვის საკმარისი არ არის და მოდელს დამატებითი სიგნალები, მაგალითად ყურადღების პატერნები ან რამდენიმე საცდელი გაშვება, სჭირდება.
რა უნდა გავითვალისწინოთ
Weight-Space Programming-ის შედეგები ერთ შედარებით პატარა ქსელებს ეყრდნობა და დამოუკიდებლად ჯერ არავის გადაუმოწმებია. Qwen-ის გაუმჯობესება ძირითადად ჩაციკვლის მოხსნას უკავშირდება და არა მოდელის „დაჭკვიანებას“. ავტორები ახლა ბენჩმარკზე მუშაობენ, რომლითაც ენობრივი მოდელების მიერ წონების კითხვისა და წერის უნარს გაზომავენ. თუ ეს მიმართულება განვითარდა, ის ნეირონული ქსელების ინტერპრეტაციასა და შესწორებას გაამარტივებს, თუმცა ჯერ ადრეა იმის თქმა, რამდენად კარგად გადავა ის დიდ მოდელებზე.
წყაროები
სხვა თემები
 OpenAI-მ LifeVal წარადგინა: შეფასების სისტემა
 Project Suncatcher: AI-ის პირველი პასუხი ორბიტიდან
 ექსპონენციალური დროის ჰიპოთეზა: Anthropic-ის Claude-მაც 3-SAT-ის ახალი ალგორითმი იპოვა