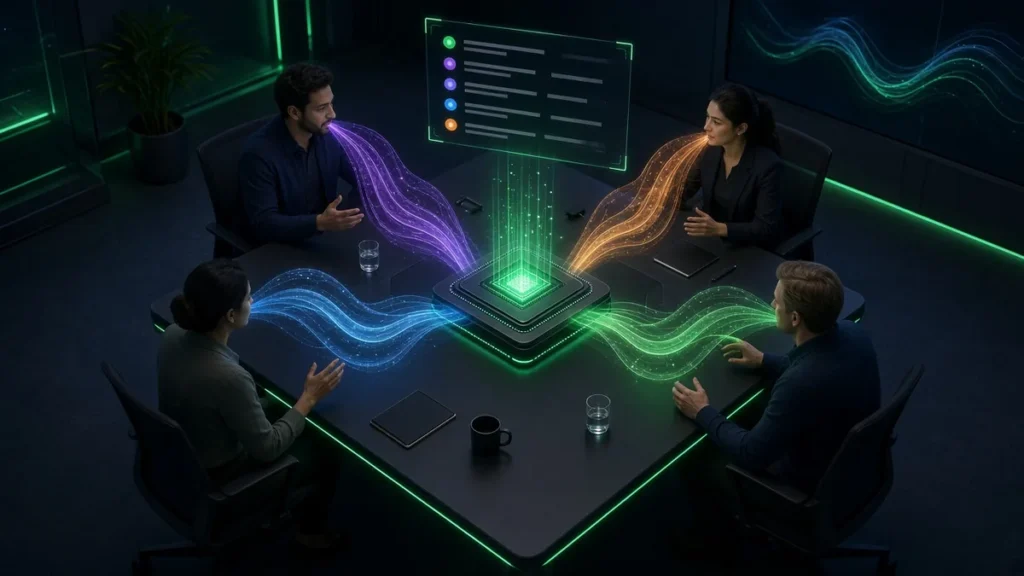
NVIDIA-მ Nemotron 3.5 Transcribe წარადგინა: ღია წონების (open-weight) მოდელი, რომელიც ჩაწერილ საუბარს ტექსტად აქცევს 40 ენაზე, არჩევს ვინ რა თქვა, თარგმნის და აუდიოზე დასმულ კითხვებსაც პასუხობს. ყველაფერი ეს ერთ მოდელში, ანუ ერთ checkpoint-შია გაერთიანებული. მოდელი უკვე ხელმისაწვდომია Hugging Face-ზე და ModelScope-ზე, დეტალები კი NVIDIA-მ huggingface-ზე გამოაქვეყნა
რას აკეთებს Nemotron 3.5 Transcribe
ჩვეულებრივი ტრანსკრიფციის ინსტრუმენტი სიტყვებს წერს, თუმცა ხშირად ვერ გეუბნება, ვინ ილაპარაკა, ან როგორ უნდა ჩაიწეროს სპეციფიკური ტერმინი. NVIDIA-ს ახალი მოდელი ამ ამოცანებს ერთად წყვეტს. ოფიციალური ბლოგის მიხედვით, მოდელი:
სარჩევი
- ტრანსკრიფციას აკეთებს 40 ენაზე;
- 31 ენიდან თარგმნის ინგლისურად და პირიქით;
- სპიკერებს არჩევს 13 ენაზე, ერთ ჩანაწერში მაქსიმუმ რვა ადამიანამდე;
- ამუშავებს ერთ საათამდე ხანგრძლივობის ჩანაწერებს;
- პასუხობს კითხვებს აუდიოზე, მაგალითად „რა გადაწყვეტილებები მიიღეს ამ შეხვედრაზე?”.
მთავარი იდეა ის არის, რომ მოდელს ჩვეულებრივი ენით ეუბნები, რა გჭირდება. X-ის თემის მესამე პოსტში NVIDIA აჩვენებს, როგორ ამატებს მოდელი შეხვედრის ჩანაწერს სპიკერების ნიშნებს, შემდეგ თარგმნის ესპანურად და იაპონურად და ბოლოს პერსონალურ მონაცემებს (PII) პოულობს და ფარავს. უცნობი ტერმინებისთვის პრომპტში შეიძლება შესაძლო სიტყვების ჩამონათვალი მიუთითო, მაგალითად სამედიცინო საუბრისას წამლის სახელები.
არქიტექტურა და ტექნიკური მონაცემები
მოდელის ბარათის მიხედვით, Nemotron 3.5 Transcribe არის Mamba-2 და Transformer-ის ჰიბრიდული Mixture of Experts (MoE) ენობრივი მოდელი, რომელსაც აუდიო ენკოდერი და სპიკერების ენკოდერი აქვს მიერთებული. საბაზისო ენობრივ მოდელად Nemotron 3.5 Lightning 30B-A3B არის გამოყენებული. სულ მოდელს 34 მილიარდი პარამეტრი აქვს, აუდიო ენკოდერის ჩათვლით, თუმცა თითოეული მოთხოვნისას მხოლოდ დაახლოებით 4.3 მილიარდი მუშაობს. სწორედ ამიტომ X-ის პოსტში ის „30B MoE მოდელად, ~4B აქტიური პარამეტრით” მოიხსენიება.
კონტექსტის სიგრძე 65 536 ტოკენია. წონები BF16, FP8 და NVFP4 ფორმატებშია გამოქვეყნებული, ხოლო NVIDIA-ს თქმით, მოდელი ერთ GPU-ზე მუშაობს, DGX Spark-იდან Blackwell-ის მონაცემთა ცენტრის სისტემებამდე. ტრენინგში 1.7 მილიონ საათზე მეტი უნიკალური აუდიო იყო გამოყენებული.
მნიშვნელოვანი შეზღუდვა: ეს ოფლაინ მოდელია. ის ჩაწერილ აუდიოს ამუშავებს და პირდაპირ ეთერში, რეალურ დროში ტრანსკრიფციისთვის არ არის განკუთვნილი.
Nemotron 3.5 Transcribe-ის შედეგები ბენჩმარკებზე
NVIDIA-ს X-ის თემის თანახმად, Nemotron 3.5 Transcribe ღია წონების მოდელებს შორის პირველია Hugging Face-ის Open ASR ინგლისურ ლიდერბორდზე, სიტყვების შეცდომის საშუალო მაჩვენებლით (WER) 5.33%. Artificial Analysis-ის რეიტინგში მისი WER 2.81%-ია, მაშინ როცა Mistral-ის Voxtral Small-ს 2.77% აქვს, თუმცა 24 მილიარდი პარამეტრით. ანუ სიზუსტე თითქმის იგივეა, აქტიური პარამეტრები კი დაახლოებით ექვსჯერ ნაკლები.
სპიკერების გარჩევაში NVIDIA მოდელს VoiceArena-ს 14-სისტემიან შედარებაში და David AI-ის მრავალენოვან ბენჩმარკზე პირველ ადგილს მიაწერს. მოდელის ბარათში მოცემული ცხრილის მიხედვით, მრავალენოვან Open ASR ლიდერბორდზე (7 ენა) მისი საშუალო WER 4.62%-ია, Qwen3-ASR-1.7B-ის 6.49%-ის წინააღმდეგ. ყველა ეს მონაცემი NVIDIA-ს მიერ არის გამოქვეყნებული.
არის თუ არა ქართული მხარდაჭერილი
მოდელის ბარათში 40 ენის სრული ცხრილია, ქართული მასში არ არის. სიაშია მაგალითად ინგლისური, რუსული, უკრაინული, თურქული, ბერძნული, არაბული, ებრაული, იაპონური და კორეული. ენების ხარისხიც განსხვავდება: ნაწილი „Leading” დონისაა, ნაწილი „Production-ready”, ზოგი კი უბრალოდ „Supported”, რაც NVIDIA-ს თქმით, შეიძლება დამატებით ფაინ-ტიუნინგს საჭიროებდეს. აუდიოზე კითხვა-პასუხი და რეზონინგი მხოლოდ ინგლისურად შეფასდა.
ქართველი დეველოპერებისთვის საინტერესო შესაძლებლობა ფაინ-ტიუნინგია. NVIDIA მოდელთან ერთად აქვეყნებს Granary v2-ს, ღია მრავალენოვანი მეტყველების მონაცემთა ნაკრებს, და NeMo Speech-ის ინსტრუმენტებს. სამედიცინო ტრანსკრიფციის მაგალითზე ფაინ-ტიუნინგმა შეცდომების მაჩვენებელი 45.8%-ით შეამცირა საუკეთესო პრომპტთან შედარებით. თუმცა ახალი ენის დამატებაზე NVIDIA კონკრეტულად არაფერს წერს.
ლიცენზია და როგორ გამოვიყენოთ
თემის ბოლო პოსტში NVIDIA წერს, რომ Nemotron 3.5 Transcribe „როგორც ყოველთვის, ღია და მორგებადია”, რაც წონებს, მონაცემებსა და რეცეპტებს მოიცავს. მოდელი OpenMDW-1.1 ლიცენზიით ვრცელდება. მისი გამოცდა შეიძლება Hugging Face-ის დემოში, საკუთარ სერვერზე გაშვება vLLM-ით, ხოლო ჰოსტინგის გარეშე გამოყენება Baseten-ის, DeepInfra-სა და Simplismart-ის API-ებით. TechCrunch-ის შეფასებით, მოდელი უპირველესად ბიზნეს შეხვედრებისა და სამედიცინო ტრანსკრიფციის აპლიკაციებს უმიზნებს.
NVIDIA ღია მოდელების ხაზს აქტიურად აფართოებს. ცოტა ხნის წინ კომპანიამ Nemotron 3.5 Super VL წარადგინა, ხოლო ხმოვან სფეროში კონკურენცია Mistral-საც აქვს, რომელმაც Voxtral 3 გამოუშვა.
შეჯამება
Nemotron 3.5 Transcribe NVIDIA-ს ღია მოდელია, რომელიც ჩაწერილი აუდიოს ტრანსკრიფციას, სპიკერების გარჩევას, თარგმანს და აუდიოზე კითხვა-პასუხს ერთ მოდელში აერთიანებს. ის 40 ენას ფარავს, ერთ საათამდე ჩანაწერებს ამუშავებს და ერთ GPU-ზე მუშაობს, NVIDIA-ს გამოქვეყნებული ბენჩმარკებით კი ღია მოდელებს შორის ლიდერობს. ქართული ჯერ მხარდაჭერილ ენებს შორის არ არის, მაგრამ ღია წონები და Granary v2 ფაინ-ტიუნინგის გზას ტოვებს.
წყაროები
სხვა თემები
 NVIDIA Meta 3 მილიარდი: NVIDIA Meta-ში ინვესტიციას დებს და Muse-ს აძლიერებს
 SpaceX 40 მილიარდი დოლარის GPU-ებს Apollo-სგან იჯარით მიიღებს
 Meta 95 მილიარდი დოლარის აქციებს გაყიდის AI ინფრასტრუქტურისა და სუპერინტელექტისთვის