OpenAI-მ წარადგინა LifeSciBench – ბენჩმარკი, რომელიც ზომავს, რამდენად კარგად ეხმარება ხელოვნური ინტელექტი ბიოლოგიური მეცნიერების რეალურ კვლევაში. პროექტი 17 ივნისს გამოქვეყნდა და ის მოდელს აფასებს არა მხოლოდ ბიოლოგიის კითხვებზე პასუხით, არამედ იმით, თუ როგორ უმკლავდება ნამდვილი კვლევის სირთულეს.
ჩვეულებრივი ბენჩმარკები ხშირად ვიწრო თემებზე ან ცალკეულ უნარებზე ფოკუსირდება, სუფთა და ერთმნიშვნელოვანი პასუხებით. LifeSciBench სხვა მიდგომას ცდის. ის ცდილობს შეაფასოს ის სამუშაო, რასაც მეცნიერი ყოველდღე აკეთებს: არასრული მონაცემების ინტერპრეტაცია, ურთიერთსაწინააღმდეგო შედეგების შეჯერება და გადაწყვეტილების მიღება გაურკვევლობის პირობებში.
სარჩევი
რა არის LifeSciBench
LifeSciBench არის ექსპერტების მიერ დაწერილი და ექსპერტების მიერ შემოწმებული ბენჩმარკი. ის მოიცავს 750 დავალებას, რომლებიც შვიდ სამუშაო პროცესსა და შვიდ ბიოლოგიურ სფეროს ფარავს.
თითოეული დავალება პრაქტიკოსი მეცნიერების შეფასებას ეყრდნობა. ესენი არიან ადამიანები, რომლებსაც აქვთ დოქტორის დონის მომზადება და უშუალო გამოცდილება წამლების შემუშავებაში ბიოტექნოლოგიურ და ფარმაცევტულ კომპანიებში.
შვიდი სამუშაო კატეგორია ასე გამოიყურება: მტკიცებულებების დამუშავება, ანალიზი, დიზაინი და ოპტიმიზაცია, სამეცნიერო მსჯელობა, ვალიდაცია და ოპერაციები, ტრანსლაცია (პრეკლინიკურიდან კლინიკურამდე გადასვლა) და სამეცნიერო კომუნიკაცია.
რიცხვები LifeSciBench-ის უკან
მასშტაბი ერთ-ერთი მთავარი ის ფაქტორია, რაც ამ ბენჩმარკს გამოარჩევს. ძირითადი ციფრები ასე გამოიყურება:
- 750 დავალება, დაწერილი ექსპერტების მიერ
- 173 მეცნიერი მონაწილე
- 1,062 დანართი: ფიგურები, PDF-ები, ცხრილები და თანმიმდევრობის ფაილები
- 19,020 შეფასების კრიტერიუმი
- 453 დამოუკიდებელი ექსპერტი შემფასებელი
როგორ შეიქმნა დავალებები
ყველა დავალება ისეა აგებული, როგორც თხოვნა, რომელსაც მეცნიერი კომპეტენტურ კოლეგას მისცემდა: სამეცნიერო დავალება, საჭირო კონტექსტი და თავისუფალი პასუხის ფორმატი. ეს არ არის ტესტი მზა, ჩასმული პასუხებით.
დავალებების უმეტესობა ერთ ნაბიჯში არ იხსნება. მათი 79% რამდენიმეეტაპიან მსჯელობას ან გადაწყვეტილებას მოითხოვს, საშუალოდ ოთხი ნაბიჯით თითო დავალებაზე.
დავალებების ნახევარზე მეტი, 53%, მოითხოვს მოდელისგან ინფორმაციის ამოღებას ან სინთეზს მინიმუმ ერთი დანართიდან. ანუ მოდელმა მხოლოდ ტექსტს კი არ უნდა დაუჯეროს, არამედ ფაილებიც წაიკითხოს და გაიაზროს.
დავალებები მკაცრ შემოწმებას გადიოდა. მიღებული დავალებები საშუალოდ ექვს ავტომატურ შემოწმების ციკლს და მინიმუმ ორ რაუნდიან ექსპერტთა შემოწმებას გადიოდა. შემფასებლებს შორის თანხმობა შესაბამის სფეროში მინიმუმ 90% იყო.
როგორ ფასდება პასუხები
თითოეული დავალება ფასდება დეტალური რუბრიკით, რომელიც მოსალოდნელ პასუხს ცალკეულ სამეცნიერო მტკიცებებად, გამოთვლებად და გადაწყვეტილებებად შლის. მთლიანობაში ბენჩმარკი 19,020 კრიტერიუმს მოიცავს, საშუალოდ 25-ს თითო დავალებაზე.
ეს მიდგომა ასახავს, როგორ ფასდება სამეცნიერო სამუშაო პრაქტიკაში. პასუხმა შეიძლება სწორ დასკვნამდე მიგვიყვანოს, მაგრამ მაინც არასრულად ჩაითვალოს, თუ ის რომელიმე მნიშვნელოვან შეზღუდვას ან ბიოლოგიურ ნიუანსს გამოტოვებს.
კონკრეტული მაგალითისთვის, ერთი დავალება ითხოვს Duchenne-ის კუნთოვანი დისტროფიის გენური თერაპიის FDA-სთვის წარსადგენი პაკეტის კრიტიკულ შეფასებას: სად ვერ უჭერს მტკიცებულება მხარს დასკვნას და რა დამატებითი მონაცემებია საჭირო. ეს კარგად აჩვენებს, რამდენად ღრმა და კონკრეტულია დავალებები.
რას აკეთებს AI კარგად და სად რჩება უკან
შედეგები ორი მაჩვენებლით იზომება. Pass rate არის დავალებების პროცენტი, რომელზეც მოდელი 70%-იან ზღვარს აღწევს. Score არის რუბრიკის საშუალო ქულა, რომელიც ნაწილობრივ კრედიტს იძლევა მაშინაც, როცა დავალება ბოლომდე არ არის ამოხსნილი.
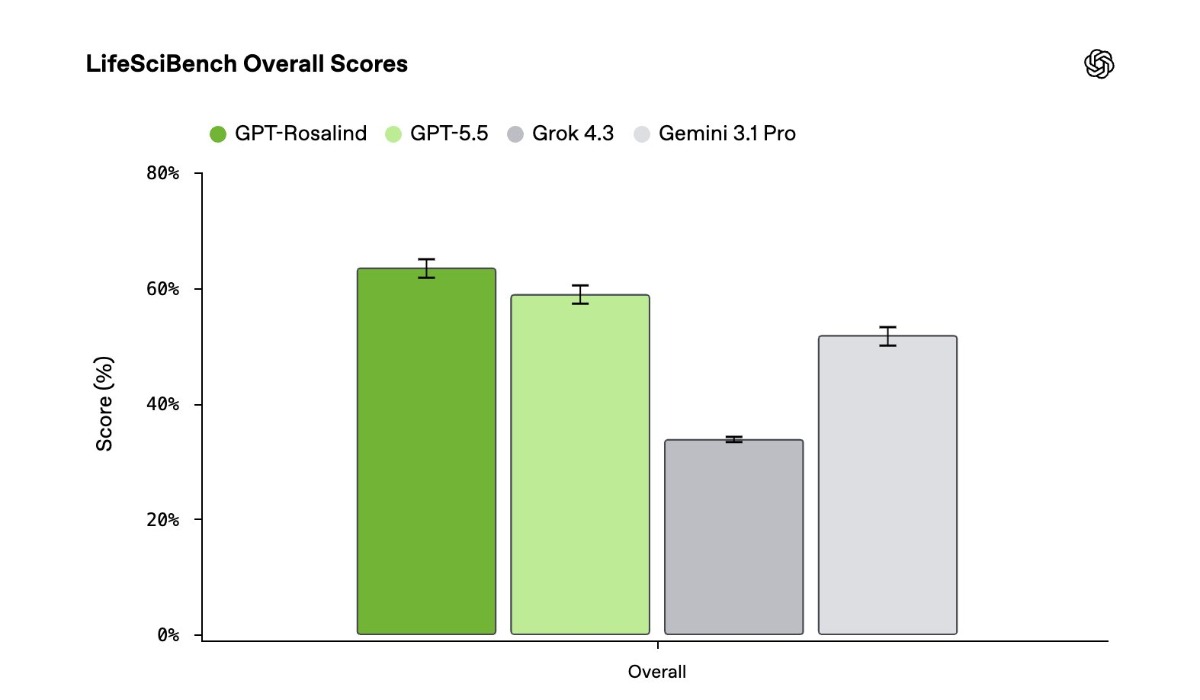
OpenAI-ის ანგარიშში GPT-Rosalind-ის შედეგი GPT-5.5-ს უპირისპირდება. საერთო pass rate 25.7%-დან 36.1%-მდე გაიზარდა. ყველაზე ძლიერი წინსვლა სამეცნიერო კომუნიკაციასა და ტრანსლაციაში ჩანს.
სუსტი მხარეებიც მკაფიოა. დიზაინი, ოპტიმიზაცია და პროგნოზირება ერთ-ერთი ყველაზე რთული კატეგორიაა, სადაც GPT-Rosalind-ის pass rate 30.7%-ია. ანალიზიც მსგავსად რთულია, 30.3%-ით.
განსაკუთრებით თვალსაჩინო სხვაობა დანართებთან მუშაობისას ჩანს. ტექსტურ დავალებებზე GPT-Rosalind-ის pass rate 45.1%-ია, მაგრამ დანართებიან დავალებებზე 28.1%-მდე ეცემა. ზუსტ რიცხვით პასუხებზე კი შედეგი მხოლოდ 14.8%-ია.
შეზღუდვები და შემდეგი ნაბიჯები
OpenAI თავადვე აღნიშნავს, რომ LifeSciBench არ ცვლის მოდელების შესწავლას რეალურ კვლევით გარემოში. ბენჩმარკი დახურულ, თვითკმარ დავალებებზე ფოკუსირდება, ხოლო ნამდვილი კვლევა იტერაციულია. მეცნიერი ახალ მტკიცებულებას აგროვებს, ჰიპოთეზებს ცვლის და გეგმას შედეგების მიხედვით არგებს.
შემდეგი ნაბიჯი ბენჩმარკის შედეგების რეალურ სამუშაო პროცესებთან დაკავშირებაა. იმის გასაზომად, აჩქარებს თუ არა AI აღმოჩენებს, საჭიროა მისი გამოყენების შესწავლა ნამდვილ კვლევით გარემოში და უფრო ხანგრძლივად.
ხშირად დასმული კითხვები
რა არის LifeSciBench?
ეს არის OpenAI-ის ბენჩმარკი, რომელიც ზომავს, რამდენად კარგად ეხმარება ხელოვნური ინტელექტი ბიოლოგიური მეცნიერების რეალურ კვლევით დავალებებში. ის 750 ექსპერტის მიერ დაწერილ დავალებას მოიცავს.
ვინ შექმნა დავალებები?
დავალებები 173-მა მეცნიერმა შექმნა, რომელთაც დოქტორის დონის მომზადება და ბიოტექნოლოგიური ან ფარმაცევტული გამოცდილება ჰქონდათ.
როგორ შედეგებს აჩვენებენ მოდელები?
შედეგები ჯერ მოკრძალებულია. GPT-Rosalind-მა საერთო pass rate 36.1%-მდე გააუმჯობესა, რაც გვიჩვენებს, რომ ბენჩმარკი ჯერ შორს არის გაჯერებისგან.
სხვა თემები
 OpenAI-მ GPT-6 Sol და GPT-6 Luna გამოუშვა
 დარიო ამოდეი: AI-ის განვითარების ტემპი უნდა შევანელოთ
 ChatGPT Data აგენტი: მონაცემები, დაშბორდები, ანალიზი