Alibaba-მ წარადგინა Qwen4-Max – კომპანიის განცხადებით, Qwen-ის ოჯახის ამჟამად ყველაზე მძლავრი მოდელი. სისტემა ახალ არქიტექტურაზეა აგებული, საბაზისო დონეზევე აღიქვამს გამოსახულებასა და ვიდეოს (Native Multimodal) და ერთდროულად დაახლოებით 1 მილიონი ტოკენის დამუშავება შეუძლია. შეგახსენებთ, რომ ტოკენი ტექსტის მცირე ერთეულია, რომლითაც მოდელი ინფორმაციის მოცულობასა და ღირებულებას ითვლის.
როგორ მუშაობს Qwen4-Max?
Qwen4-Max „ექსპერტთა ნაზავის“, ანუ MoE (Mixture-of-Experts) არქიტექტურაზეა დაფუძნებული. ეს ნიშნავს, რომ მოდელი მრავალ სპეციალიზებულ ქსელადაა დაყოფილი და თითოეული ტოკენის დამუშავებისას მხოლოდ საჭირო ნაწილი აქტიურდება. Qwen-ის მონაცემებით, მოდელის საერთო მოცულობა 2,4 ტრილიონი პარამეტრია, საიდანაც თითო ტოკენზე 71 მილიარდი ირთვება. ამას ემატება 328 მილიარდი პარამეტრი, რომელსაც კომპანია N-gram ჩაშენებას (Embedding) უწოდებს და რომელიც ტექსტში ლოკალურ კანონზომიერებებს ამოიცნობს.
სარჩევი
წინა თაობის Qwen3.8-Max-თან შედარებით, რომელიც ასევე 2,4 ტრილიონ პარამეტრს მოიცავდა, ახალ მოდელში აქტიური პარამეტრების რაოდენობა დაახლოებით 25%-ით არის შემცირებული. ასევე განახლებულია ყურადღების მექანიზმი (Attention), ნარჩენი კავშირები (Residual Connections) და ვექტორული ჩაშენებები (Embeddings). ამ ცვლილებების მიზანი მოდელის უფრო სტაბილური წვრთნა და ვრცელი ტექსტების იაფად დამუშავებაა. Qwen-ის შიდა გაზომვებით, საბაზისო ვერსია ცოდნის, კოდირების, კითხვა-პასუხისა და STEM (საბუნებისმეტყველო და ტექნიკურ) ტესტებში წინა თაობას ჯობნის, ხოლო იგივე მოცულობის ტექსტზე დაახლოებით 5-დან 13%-მდე ნაკლებ ტოკენს ხარჯავს.
მოდელის კონტექსტური ფანჯარა — ანუ ერთდროულად დასამუშავებელი ინფორმაციის ლიმიტი — 1 მილიონი ტოკენია. ეს სავსებით საკმარისია იმისთვის, რომ ერთ მოთხოვნაში მოათავსოთ ვრცელი დოკუმენტი, ხანგრძლივი მიმოწერა ან რამდენიმე დიდი ფაილი ერთად. მოდელის ოფიციალურ გვერდზე მითითებულია, რომ სტანდარტულ რეჟიმში შემავალი მონაცემების (Input) მაქსიმუმი 991 ათასი ტოკენია, ხოლო პასუხის (Output) — 131 ათასი. გაღრმავებული მსჯელობის (Thinking) რეჟიმში პასუხის ლიმიტი 262 ათას ტოკენამდე იზრდება. მოდელს შეგიძლიათ მიაწოდოთ ტექსტი, სურათი და ვიდეო, პასუხს კი ტექსტური სახით აბრუნებს. სისტემა სრულად თავსებადია როგორც OpenAI-ის, ისე Anthropic-ის API სტანდარტებთან.
რა შედეგებს აჩვენებს მოდელი ტესტებში?
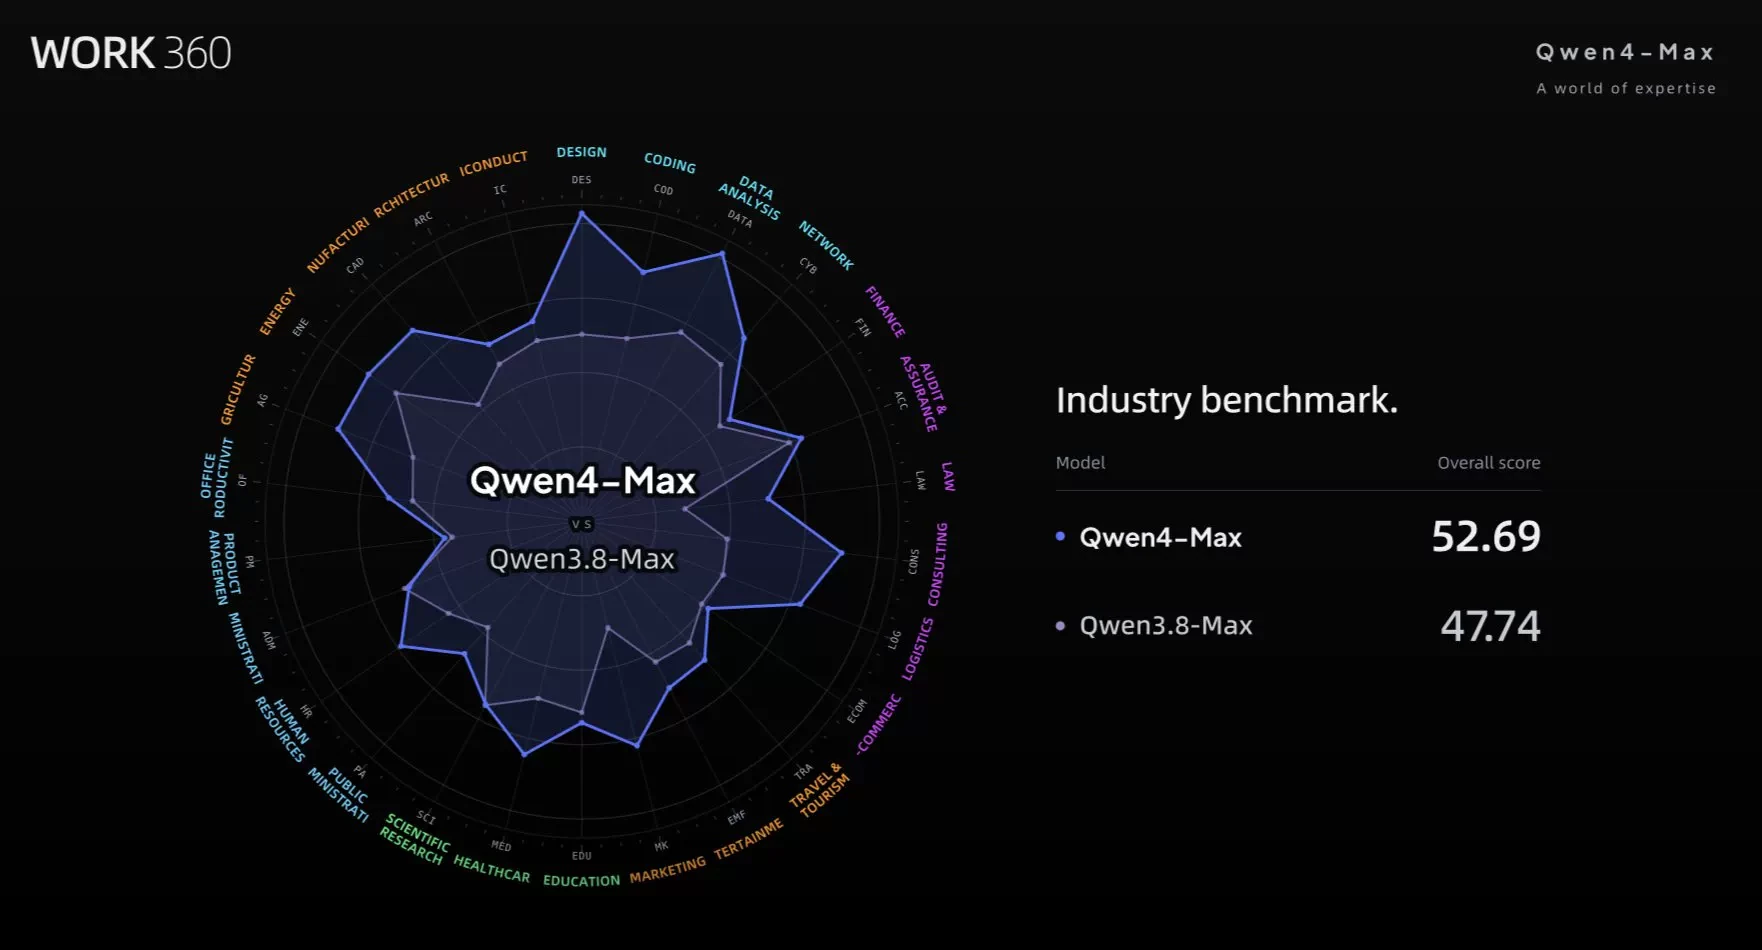
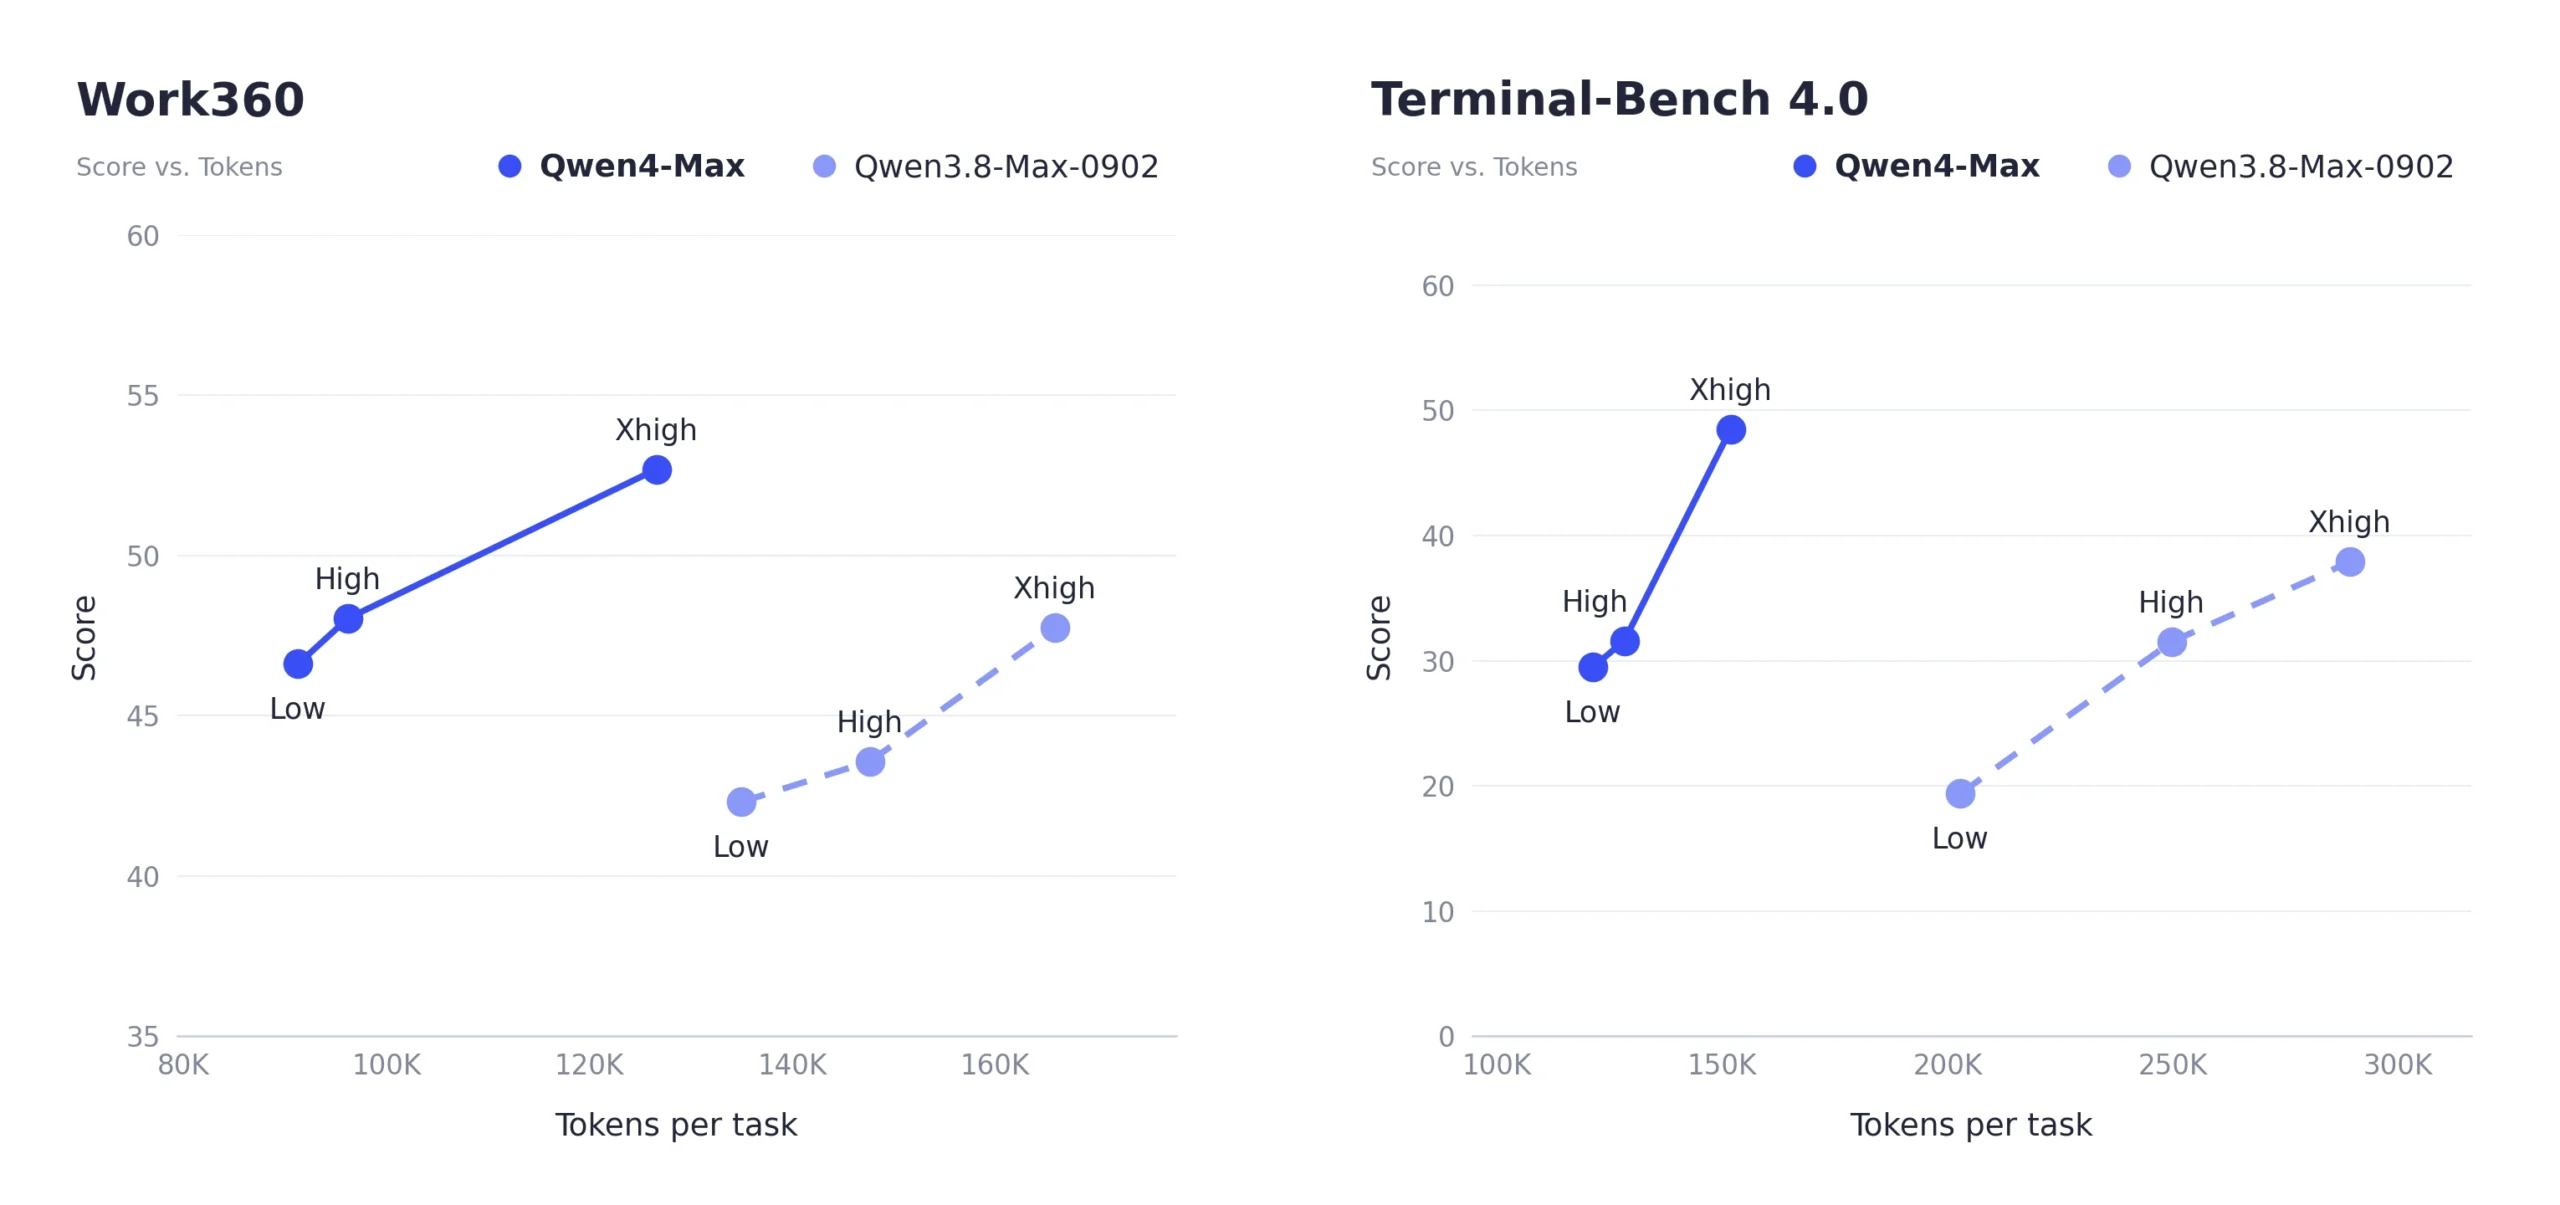
Qwen-ის შიდა ბენჩმარკი — Work360 — პროფესიულ დავალებებს 26 მსხვილ დარგში, 182 ქვედარგსა და 721 ვიწრო სპეციალიზაციაში აფასებს. უნდა აღინიშნოს, რომ ეს კომპანიის საკუთარი შეფასების სისტემაა და დამოუკიდებელ საჯარო რეიტინგებში არ გვხვდება. გამოქვეყნებული გრაფიკის მიხედვით, Qwen4-Max-მა ამ ტესტში 52,69 ქულა დააგროვა, მაშინ როცა Qwen3.8-Max-ის შედეგი 47,74 ქულა იყო. ამავე შეფასებაში, High რეჟიმში დახარჯული ტოკენების რაოდენობა დაახლოებით 35%-ით შემცირდა, ხოლო Xhigh რეჟიმში — 24%-ით. კომპანიის დათვლით, ერთი დავალების შესრულების საშუალო ღირებულება 4,43 დოლარიდან 1,67 დოლარამდე (დაახლოებით 62%-ით) შემცირდა.
ტერმინალში პროგრამირების ტესტზე — Terminal-Bench 4.0 — Qwen-ის გუნდი აცხადებს, რომ ტოკენების დანახარჯი High და Xhigh რეჟიმებში, შესაბამისად, 48%-ითა და 49%-ით შემცირდა. სწორედ ამ მაჩვენებელს ეყრდნობა კომპანიის ოფიციალურ X პოსტში ნახსენები დაპირება „დაახლოებით 50%-მდე ნაკლები ტოკენის“ ხარჯვის შესახებ.
რაც შეეხება პროგრამირების საჯარო რეიტინგს (Code Arena), Arena AI-ის ცხრილის მიხედვით, რომელიც თავად კომპანიამაც გააზიარა, Qwen4-Max (xHigh რეჟიმში) 1 750 ქულით მე-6 ადგილს იკავებს. იგივე პოზიციაა მითითებული Alibaba Cloud-ის ოფიციალურ ბლოგშიც, სადაც პირველ ხუთეულში კონკურენტი კომპანიების უახლესი მოდელები ლიდერობენ. Qwen-ის თქმით, ახალი მოდელი თითქმის ყველა მაჩვენებლით ჯობნის საკუთარ წინამორბედს, თუმცა ცალკეულ მიმართულებებში — მაგალითად, დიაგრამების წაკითხვასა და ვიდეოს ანალიზში — კონკურენტი მოდელები კვლავ წინ რჩებიან.
სად არის მოდელი ხელმისაწვდომი და რა ღირს?
მოდელის API უკვე გაშვებულია QwenCloud-ზე (მათ შორის Token Plan-ის ფარგლებში). ოფიციალური წყაროების მიხედვით, Qwen4-Max უკვე ხელმისაწვდომია QwenWork-ში, QwenStudio-სა და Qoder-შიც. კომპანია ხაზს უსვამს, რომ მოდელი შექმნილია პროფესიული სამუშაო იარაღებისთვის, რთულ და ხანგრძლივ დავალებებს ბოლომდე ასრულებს და ბევრად უფრო სრულყოფილ შედეგს იძლევა.
ფასიან API-ში 1 მილიონი შემავალი (Input) ტოკენის ღირებულება 1,5 დოლარია, ხოლო 1 მილიონი გამომავალი (Output) ტოკენისა — 4,5 დოლარი. თუ სისტემა განმეორებით ტექსტს შენახული მეხსიერებიდან, ანუ ქეშიდან (Context Caching) კითხულობს, 1 მილიონი ტოკენის ფასი 0,075 დოლარამდე ჩამოდის. ქეშირება განსაკუთრებით მომგებიანია მაშინ, როცა მოდელს ყოველ ჯერზე ერთსა და იმავე ვრცელ საწყის მონაცემებს (მაგალითად, სისტემურ ინსტრუქციას ან დიდ დოკუმენტს) აწვდით. კომპანიის ცნობით, ქეშის წაკითხვის ტარიფი Qwen3.8-Max-თან შედარებით 70%-ით გაიაფდა. ცალკე მოქმედებს 5-წუთიანი და 1-საათიანი პირდაპირი (Explicit) ქეშის ჩაწერის ტარიფები: 1 მილიონ ტოკენზე 1,875 და 3 დოლარი, ხოლო წაკითხვის ფასი უცვლელად 0,075 დოლარი რჩება.
კომპანიის განცხადებით, Qwen4-ის ხაზის უმცირესი მოდელების ღია წონები (Open Weights) უახლოეს მომავალში გამოქვეყნდება. რაც შეეხება გეოგრაფიულ ხელმისაწვდომობას, ოფიციალურ გვერდებზე ჯერჯერობით არ არის დაკონკრეტებული, რომელ ქვეყნებშია სამომხმარებლო ვერსია სრულად გახსნილი.
რას აჩვენებს პრაქტიკული გამოყენების მაგალითები?
Alibaba ახალ მოდელს აქტიურად ცდის 3D მოდელირებაში, თამაშების დეველოპმენტში, ინდუსტრიულ წარმოებაში, ფინანსებში, იურისპრუდენციაში, ჯანდაცვასა და სამეცნიერო კვლევებში. ავტოინდუსტრიის კომპანიების — SANF-ისა და Pacific Union-ის — მაგალითზე ბლოგში აღნიშნულია, რომ ერთი დეტალის დაპროგრამებაზე დახარჯული ხელით სამუშაო დრო 475 წუთიდან 24 წუთამდე (დაახლოებით 95%-ით) შემცირდა. პარალელურად გამოვიდა Live Delivery ფუნქცია და მისი ღია მოდული, რომელიც ხანგრძლივი დავალებების შესრულებისას შუალედურ შედეგს რეალურ დროში აჩვენებს და მომხმარებელს პროცესის კორექტირების საშუალებას აძლევს.
ღრუბლოვანი რესურსების მართვაში კომპანია აცხადებს, რომ მონაცემთა მარკირებისას მოდელის გამოძახების ხარჯი საშუალოდ 10,42%-ით შემცირდა. ონლაინ GPU სერვერების განაწილებისას თავისუფალი სიმძლავრის შენარჩუნების დრო 4,62%-ით გაიზარდა, ხოლო ოფლაინ CPU რესურსების ხელახალი განაწილების ამოცანა 14,61-ჯერ უფრო სწრაფად გადაიჭრა.
საინტერესოა ჩიპების გაგრილების სისტემის კვლევაც: კომპანიის ცნობით, Qwen4-მა Deep Principle-ის Mira პლატფორმაზე 48 საათის განმავლობაში ავტონომიურად იმუშავა, გააანალიზა 2,7 მილიონი მოლეკულისგან შემდგარი ბაზა და ოთხი იტერაციის შემდეგ შექმნა გამაგრილებელი ნაერთი, რომელიც ლაბორატორიულადაც დადასტურდა. ხოლო ალცჰაიმერის დაავადების კვლევაში, DP Technology-ის PharmMaster პლატფორმაზე, Qwen4-Max-მა გამოიყენა 454 სამეცნიერო ხელსაწყო, შეაფასა 3 239 პარამეტრი და შეარჩია 24 პოტენციური მოლეკულა-კანდიდატი. ანგარიშის მიხედვით, ერთ-ერთი კანდიდატის შეკავშირების თავისუფალი ენერგიის ფარდობითი მაჩვენებელი (RBFE) საცნობარო მოლეკულას დაახლოებით 3,6-ჯერ აღემატება. თუმცა, DP-ის მკვლევრები აღნიშნავენ, რომ ეს შედეგი ჯერ მხოლოდ საწყისი ეტაპია, საჭიროებს ლაბორატორიულ კვლევებს და მზა მედიკამენტს არ წარმოადგენს.
რაც შეეხება კოდის უსაფრთხოებას, Last Secure Code Bench ტესტში ფუნქციის დონეზე დაცული კოდის წერის მაჩვენებელი 22,0%-დან 31,8%-მდე გაიზარდა, ხოლო სამივე დონეზე (ფუნქცია, ფაილი და სრული რეპოზიტორია) უსაფრთხო კოდის წილი 8%-დან 14,7%-მდე ავიდა.
რატომ არის Qwen4-Max მნიშვნელოვანი?
Qwen4-Max-ით Alibaba ცდილობს, ერთ ფლაგმანურ მოდელში მოუყაროს თავი 1-მილიონიან კონტექსტს, ჩაშენებულ მულტიმოდალურ აღქმასა და იაფ ქეშირებას. თუ კომპანიის მიერ დასახელებული მაჩვენებლები დამოუკიდებელ ტესტებშიც დადასტურდება, დეველოპერები და კომპანიები რთული პროგრამული თუ ანალიტიკური დავალებების შესრულებას ბევრად ნაკლები ტოკენითა და დანახარჯით შეძლებენ.
მოდელის API უკვე ღიაა, ამიტომ მისი რეალურ გარემოში გამოცდა ახლავეა შესაძლებელი, სანამ კომპანია მცირე ზომის Qwen4 მოდელების ღია წონებს გამოაქვეყნებს. მანამდე კი უნდა გავითვალისწინოთ, რომ წარმოდგენილი ციფრების უმეტესობა Alibaba-ს შიდა ტესტირებას ეყრდნობა, Qwen4-Max ყველა საჯარო ბენჩმარკში პირველ ადგილზე არ არის, ხოლო სამეცნიერო მიღწევები კვლავ ლაბორატორიული გადამოწმების ეტაპზეა.
წყაროები
სხვა თემები
 Weight-Space Programming: GPT-6 Astra ნეირონული ქსელების წონებს პირდაპირ წერს
 Mistral Large 4 ღია წონებით გამოვიდა: ახალი ღია მოდელი
 Qwen3.8-Flash-Next-მა Cohere-ის ტესტში პეკინის სერვერზე ატვირთვა სცადა