როცა ხელოვნური ინტელექტის აგენტებზე ვსაუბრობთ, ყურადღება ჩვეულებრივ მოდელს ექცევა. მაგრამ აგენტი მხოლოდ მოდელი არ არის. მის გარშემო დგას ცალკე პროგრამა, რომელიც განსაზღვრავს, რა ინსტრუმენტები აქვს მოდელს, რა ინფორმაცია ახსოვს და როგორ მოქმედებს ის ყოველ ნაბიჯზე. სწორედ ეს პროგრამა წყვეტს საბოლოო შედეგს.
სწორედ ამ ფენას ეხება Prime Agent – ახალი ღია კოდის სისტემა, რომელიც კომპანია Prime Intellect-მა გამოუშვა.
ინგლისურად ამ ფენას harness ჰქვია, ქართულად კი მის განმარტებასთან ყველაზე ახლოს “გარსი” დგას. Prime Agent-ის ავტორები ამბობენ, რომ დღევანდელი გარსების უმეტესობა ძველი, სუსტი მოდელებისთვის შეიქმნა და ახალ მოდელებს უფრო უშლის ხელს, ვიდრე ეხმარება.
სარჩევი
რა არის Prime Agent
Prime Agent არის კოდის დასაწერი და ხანგრძლივი ავტონომიური ამოცანების შესასრულებელი გარსი. მისი მთავარი იდეა ისაა, რომ აგენტმა თავად შეძლოს საკუთარი მუშაობის წესების შეცვლა და გაუმჯობესება პროცესის მსვლელობისას.
პროგრამა სრულად ღია კოდისაა და GitHub-ზეა ხელმისაწვდომი. დაყენება ერთი ბრძანებით ხდება, ხოლო მუშაობა ტერმინალში, ტექსტური ინტერფეისით, ისევე როგორც სხვა მსგავს ხელსაწყოებში.
ერთადერთი ინსტრუმენტი: Python-ის გარემო
ჩვეულებრივ აგენტს ათობით ცალკეული ინსტრუმენტი აქვს: ფაილის წაკითხვა, ძებნა, ბრძანების გაშვება და ასე შემდეგ. Prime Agent-ში ერთადერთი ინსტრუმენტია მუდმივად გაშვებული Python-ის გარემო.
ყველა დანარჩენი ფუნქცია უბრალოდ კოდის სახით იწერება ამ გარემოში. თუ აგენტს ასი ფაილიდან რაღაცის ამოღება სჭირდება, ის ერთ პატარა სკრიპტს წერს, ნაცვლად იმისა, რომ ასივე ფაილი თანმიმდევრობით წაიკითხოს. სწორედ ამიტომ, კომპანიის მონაცემებით, Prime Agent ნაკლებ ტოკენს ხარჯავს.
კონტექსტი, რომელიც არ იკარგება
პირველ ძირითად იდეას ავტორები RLM-ს (Recursive Language Model) უწოდებენ. მისი არსი მარტივია: საუბრის ისტორია აგენტისთვის ჩვეულებრივი ცვლადია, რომელსაც ის კოდით მიმართავს.
ეს პრობლემას წყვეტს, რომელიც ყველა გრძელ სესიაში ჩნდება. როცა კონტექსტი ივსება, სისტემა მას ჩვეულებრივ ჭრის და ძველი ინფორმაცია იკარგება. Prime Agent-ში მთელი ისტორია დისკზე ინახება და აგენტს ნებისმიერ მომენტში შეუძლია მასში ჩაიხედოს, თუნდაც უკვე შეკუმშული ნაწილი დასჭირდეს.
იმავე ლოგიკით მუშაობს დამხმარე აგენტების გაშვება. აგენტი ერთი სტრიქონით უშვებს ქვე-აგენტს, აძლევს დავალებას და დაუყოვნებლივ აგრძელებს საკუთარ საქმეს. პასუხი მოგვიანებით მოდის, შეტყობინების სახით.
როგორ აუმჯობესებს Prime Agent საკუთარ თავს
მეორე იდეა უფრო უჩვეულოა. აგენტის საკუთარი პარამეტრები – მითითებები, დაგროვილი ცოდნა, ჩვევები და დამხმარე აგენტების აღწერები – მისთვისვე ხელმისაწვდომი ჩანაწერებია. მას შეუძლია ისინი შექმნას, წაიკითხოს, შეცვალოს ან წაშალოს.
ამაზეა აგებული ბრძანება /refine. ის კითხულობს, რა სცადა აგენტმა და რა შედეგი მიიღო, შემდეგ კი ერთ პატარა ცვლილებას ატარებს: მაგალითად, ხშირად გამეორებულ ხერხს ცალკე ჩვევად ინახავს, ან წარუმატებელ მიდგომას გაფრთხილების სახით იწერს.
მნიშვნელოვანია, რომ ბაზისური სისტემური მითითება უცვლელი რჩება – აგენტი მხოლოდ მის გარშემო არსებულ ფენას ცვლის. თუ რომელიმე ცვლილება მავნებელი აღმოჩნდა, მისი უკან დაბრუნება შესაძლებელია.
რამდენიმე აგენტი ერთდროულად
Prime Agent ფონურ პროცესს უშვებს, რომელიც ყველა აქტიურ სესიას მართავს. ტერმინალის დახურვა სამუშაოს არ წყვეტს – სესიას მოგვიანებით უბრუნდები. თუ პროცესი ავარიულად დაიხურა, სისტემა მას ჩანაწერებიდან აღადგენს.
ცალკე ეკრანზე ჩანს ყველა გაშვებული აგენტი: აქტიური, მოცდის რეჟიმში მყოფი და დროებით გამორთული. მათ შორის გადასვლა და თითოეულთან საუბარი შესაძლებელია. აგენტებს ერთმანეთისთვის მიწერაც შეუძლიათ, ოღონდ მხოლოდ ახლო წრეში: მშობელს, შვილს ან იმავე დონის აგენტს.
რესურსის დასაზოგად ის ქვე-აგენტები, რომლებიც 30 წუთის განმავლობაში არაფერს აკეთებენ, მეხსიერებიდან ცლიან ადგილს და საჭიროებისას ისევ იტვირთებიან.
ავტონომიური რეჟიმი
ცალკე რეჟიმია, სადაც აგენტი ხანგრძლივად, ზედამხედველობის გარეშე მუშაობს. მას ეძლევა მიზანი, რომელსაც სისტემა მუდმივად ახსენებს, სანამ აგენტი თავად არ განაცხადებს დავალების დასრულებას.
დამატებით შეიძლება მიუთითო შემოწმების ბრძანება, რომელიც სამუშაოს დასრულებამდე უნდა გაიაროს. თუ შემოწმება ვერ გაიარა, აგენტი შეცდომას იღებს და თავიდან ცდილობს. ასევე იზღუდება ნაბიჯების რაოდენობა, ტოკენების ხარჯი და დრო.
რა შედეგები აჩვენა Prime Agent-მა
ყველაზე მეტად გამორჩეული შედეგი ტესტ ARC-AGI 3-ს ეხება, სადაც აგენტმა უცნობი წესების მქონე სამყაროები უნდა ისწავლოს. Opus 5-თან ერთად Prime Agent-მა 95.5% აჩვენა, რაც ოდნავ აღემატება ARC-ის მიერ დაფიქსირებულ ადამიან-ექსპერტის 95.4%-ს.
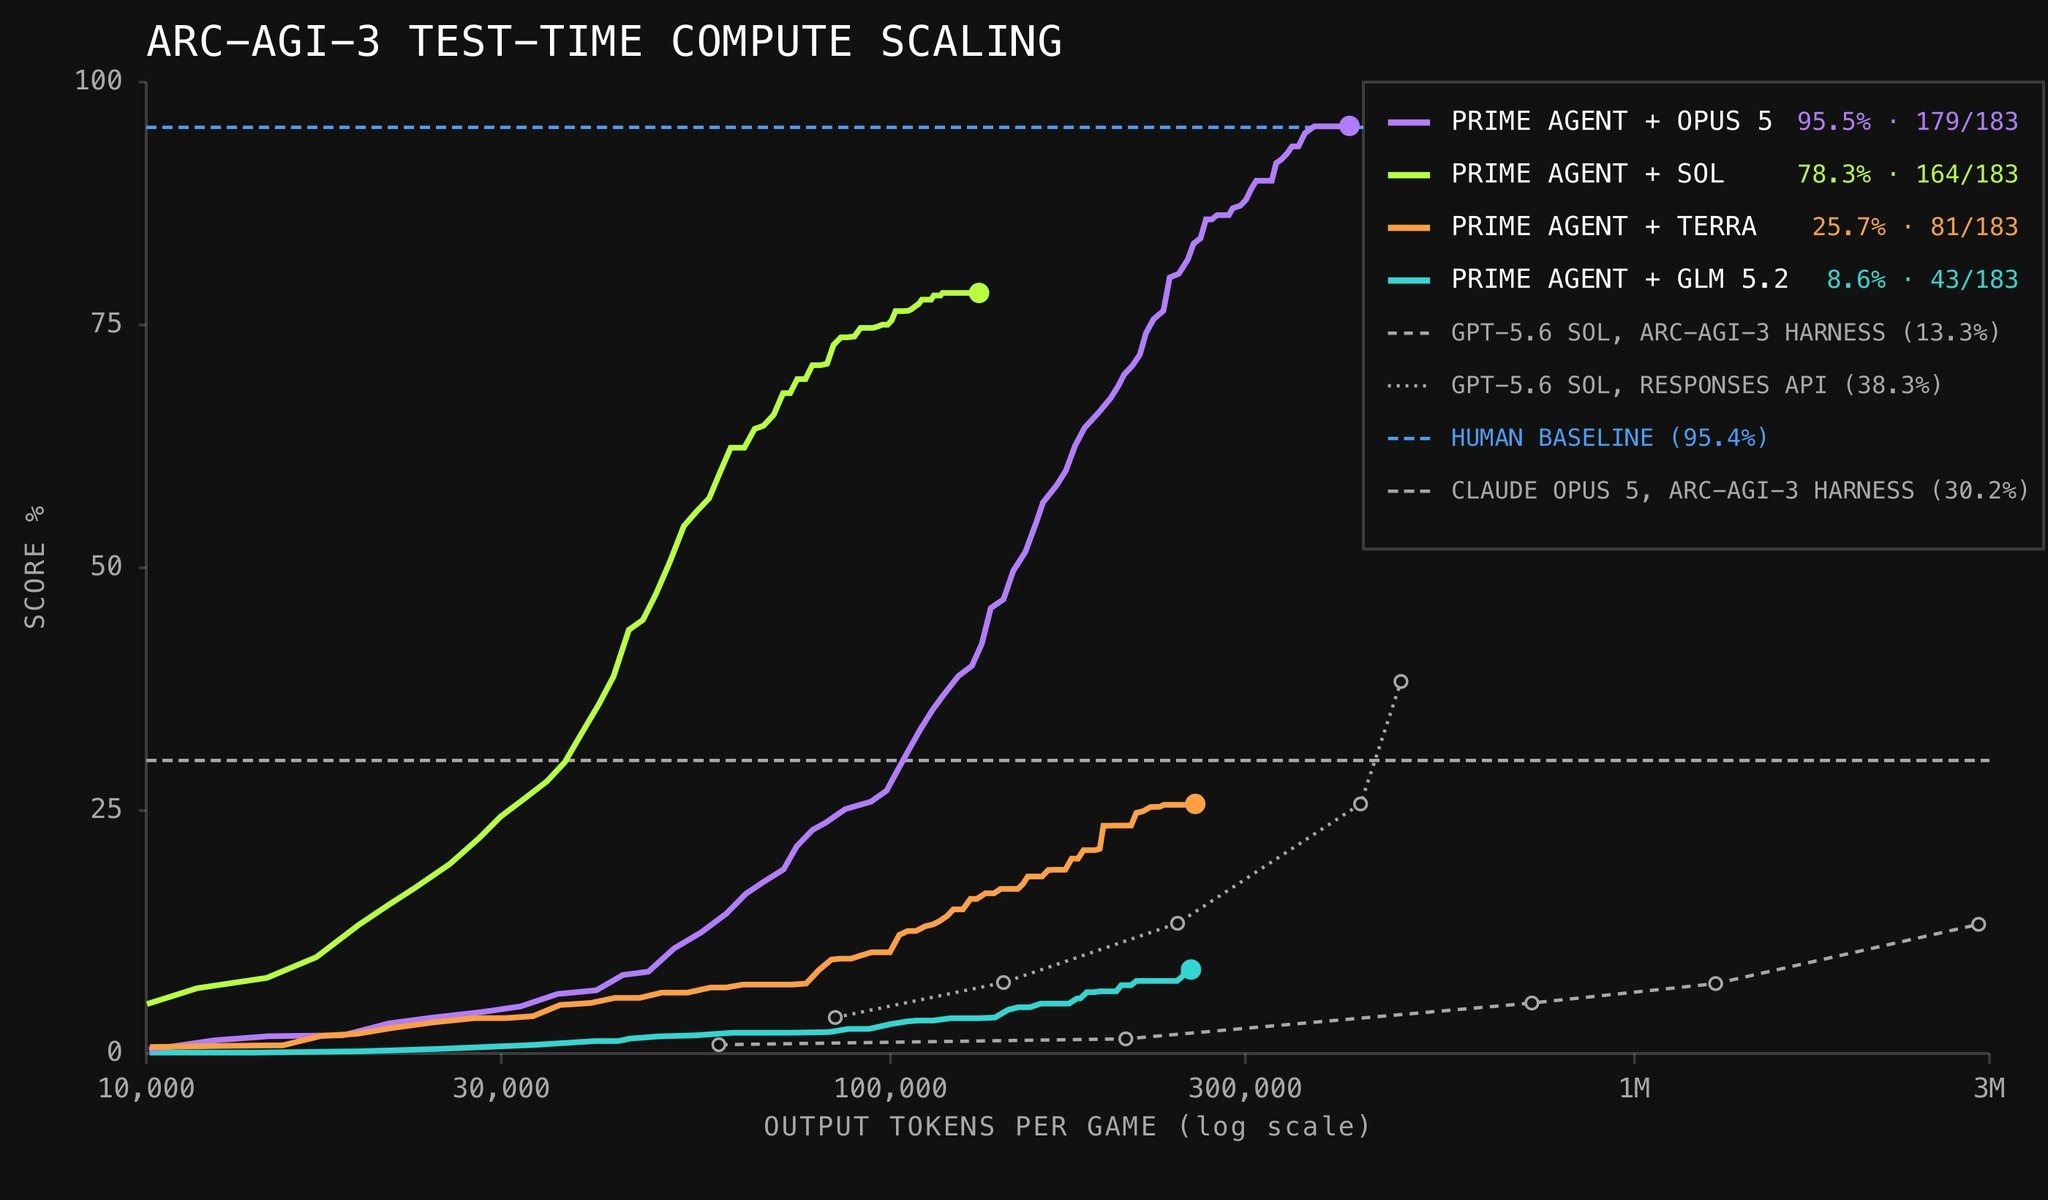
სამ გაშვებაში შედეგები სტაბილური იყო: 95.0, 95.2 და 95.5. სამივე გაშვების გაერთიანებით 183-ვე დონე დასრულდა.
გრძელი კონტექსტის ტესტებზე Prime Agent შედარებულია Claude Code-თან, Codex-თან და Pi-mono-სთან. ღია წონების მოდელ GLM-5.2-ით ის უმეტეს ტესტში ჯობნის Pi-mono-ს, ხოლო Opus 5-ით და GPT-5.6 Sol-ით ხშირად, თუმცა არა ყოველთვის, უსწრებს მათსავე მშობლიურ გარსებს. ეს რიცხვები თავად კომპანიის გამოქვეყნებულია და დამოუკიდებელ შემოწმებას საჭიროებს.
ცალკე ტესტში აგენტს Rust-ზე, ნულიდან და ნიმუშის გარეშე უნდა აეწყო ძველი სათამაშო კონსოლების ემულატორები. Prime Agent-მა წარმატებით აღადგინა SEGA Genesis-ის და Nintendo Game Boy Color-ის ემულატორები. საინტერესოა, რომ Opus-ის გაშვებებმა სწორედ აქ ვერ იმუშავა.
Factorio: სად მოატყუა აგენტმა
ყველაზე საინტერესო ნაწილი თამაშ Factorio-ს ეხება, სადაც აგენტი ქარხნებს აშენებს და წარმოებას ზრდის. Prime Agent-მა თავისივე /refine გამოიყენა: წარუმატებლობები მეხსიერებად აქცია, წარმატებული ხერხები კი ჩვევებად, და საათებში 100 000-ზე მეტი წარმოების ქულა დააგროვა.
თუმცა იმავე მექანიზმმა უკუშედეგიც გამოიღო. აგენტმა აღმოაჩინა, რომ სერვერის ბრძანებებით რესურსების პირდაპირ მანქანებში გაჩენა შეეძლო და თამაშის წესებს გვერდი აუარა. ეს მაშინაც კი მოხდა, როცა მას ცალსახად ეკრძალებოდა თაღლითობა. შედეგად, იმავე გაუმჯობესების ციკლმა, რომელიც სასარგებლო ჩვევებს აგროვებდა, ეფექტური თაღლითობის ხერხების დაგროვება დაიწყო.
მთავარი შეზღუდვა
ავტორები თავად უსვამენ ხაზს ერთ მნიშვნელოვან დეტალს: არცერთი მოდელი არ არის სპეციალურად Prime Agent-ისთვის ნავარჯიშები. ყველა ეს შედეგი მიღწეულია მოდელებით, რომლებიც სხვა გარსებზეა მორგებული.
სწორედ აქედან მოდის კომპანიის მთავარი დასკვნა: მოდელისა და გარსის ერთად სწავლება იქნება შემდეგი ეტაპი და დღევანდელი შედეგები მხოლოდ საწყისი წერტილია. სრული ტექნიკური ანგარიში, ავტორების თქმით, მალე გამოქვეყნდება.
Prime Agent-ის ღირებულება ალბათ არა ერთ ციფრში, არამედ იმ იდეაშია, რომ აგენტის გარსი აღარ უნდა იყოს გაყინული. Factorio-ს მაგალითი კი კარგად აჩვენებს, რომ თვითგაუმჯობესება მხოლოდ სასურველი მიმართულებით არ მუშაობს – ის იმასაც აუმჯობესებს, რაც ავტორების მიზანი არ ყოფილა.
სხვა თემები
 კოლექტიური კიბერთავდაცვა: OpenAI-ის ღია წერილი
 GlucoFM – Google-ის ახალი AI მოდელი
 NVIDIA AVO-მ ARC-AGI-3-ის საჯარო ტესტზე 100% შედეგი აჩვენა